

Записать экран быстрее, чем написать инструкцию. Через месяц выясняется, что нужный фрагмент в этом видео никто найти не может.
Скринкаст на двенадцать минут выглядит как готовая документация. Человек показал, как настраивается сервис, проговорил все шаги, ролик лежит в базе знаний. Проблемы начинаются, когда по этой инструкции кто-то работает.
Почему видео плохо работает как документация
В тексте есть поиск. В видео его нет. Коллега помнит, что про переменные окружения было «где-то в середине», и отматывает ползунок наугад.
Команду из ролика нельзя скопировать. Её переписывают руками, с опечаткой в одном символе, и потом полчаса разбираются, почему не работает.
Видео нельзя посмотреть глазами по диагонали. Чтобы понять, подходит ли ролик к твоей задаче, придётся потратить те же двенадцать минут. Текст на такой же объём просматривается за полминуты.
Наконец, видео не сравнивается версиями. Что изменилось между записью прошлого года и новой, покажет только полный просмотр обеих.
Отсюда простой вывод: ролик стоит оставить, а рядом положить текстовую версию. Она берёт на себя поиск и копирование, видео – показ интерфейса.
Что должно попасть в текст
Дословная расшифровка на двенадцать минут – это примерно две тысячи слов, половина из которых «так, сейчас, смотрите». Читать её никто не станет.
Полезная текстовая версия состоит из другого:
- последовательность шагов, пронумерованная
- команды и конфиги – дословно, моноширинным шрифтом
- значения параметров, которые в ролике проговорены голосом
- предупреждения вида «если сделать наоборот, сервис не поднимется»
- два-три скриншота ключевых экранов.
Всё остальное из расшифровки можно выбросить. Она нужна как черновик, а не как результат.
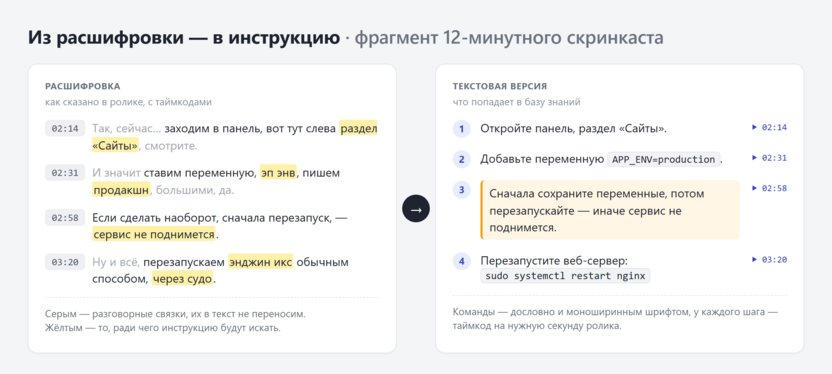
Разговорные связки уходят. Шаги, команды, значения и предупреждение остаются, у каждого шага – таймкод.
Как это делается за один подход
Шаг 1. Записать с нормальным звуком. Гарнитура вместо микрофона ноутбука экономит потом полчаса вычитки. Хуже всего распознаются тихая речь и два голоса одновременно.
Шаг 2. Получить расшифровку автоматически. Сервис распознавания речи отдаёт текст за минуты. Вручную двенадцать минут записи расшифровывают около часа.
Шаг 3. Вычитать опасные места. Это команды, пути, версии и числа. Всё остальное можно просмотреть бегло.
Шаг 4. Переписать в шаги. Из расшифровки остаётся структура: что за чем идёт. Разговорные связки убираются, каждый шаг начинается с глагола.
Шаг 5. Положить текст рядом с видео. В той же статье базы знаний, над плеером или под ним. Разнесённые по разным местам текст и ролик расходятся уже на второй правке.
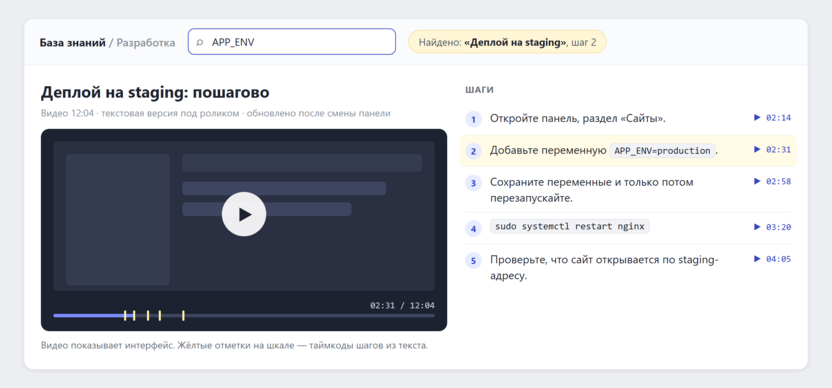
Так выглядит результат: поиск по базе находит шаг с нужной переменной, а таймкод у шага открывает это место ролика.
Где автоматическая расшифровка ошибается
Ошибается она предсказуемо, и это удобно. Страдают термины, англицизмы и всё, что произносится по буквам.
nginx превращается в «энджин икс», sudo – в «судо», номер версии 1.24 – в «один двадцать четыре». Названия внутренних сервисов распознаются как придётся, особенно если это выдуманное слово.
Приём, который экономит время: перед вычиткой выписать список терминов, которые звучали в ролике. Дальше проверка идёт по короткому списку через поиск, а не сплошным чтением.
Для ролика из примера такой список выглядит так:
| В расшифровке | В инструкции |
|---|---|
| эп энв | APP_ENV |
| продакшн | production |
| энджин икс | nginx |
| судо | sudo |
| один двадцать четыре | 1.24 |
Ещё помогает проговаривать команды медленно и целиком, а не «ставим нжинкс обычным способом». Это и для зрителя лучше.
Зачем в техническом тексте таймкоды
Таймкод – это ссылка из текста в нужную секунду видео. В инструкции он закрывает случай «словами объяснить сложно, посмотри, как это выглядит».
Второе применение – спорные места. Если в расшифровке команда выглядит странно, по таймкоду за пару секунд открывается то самое место записи, и слышно, что было сказано на самом деле.
Разделение по спикерам нужно, когда запись парная: один показывает, второй задаёт вопросы. Без разметки реплики слипаются, и потом непонятно, кто из двоих был прав.
Что это даёт команде
Инструкция начинает находиться поиском по базе знаний. Это главное: ролик, который нельзя найти, для команды не существует.
Новый человек читает текст за три минуты вместо двенадцати и смотрит видео только там, где не понял.
Обновлять тоже проще. Поменялся один шаг – правится абзац, а не перезаписывается ролик целиком.
Мы в команде AudioVText делаем сервис расшифровки аудио и видео в текст, и такие задачи для него типовые. AudioVText распознаёт речь, расставляет таймкоды и делит запись по участникам. Основной язык – русский, всего поддерживается 99 языков. Файл можно загрузить или вставить ссылку на видео с YouTube, VK Видео, Rutube или OK.ru. Готовый текст выгружается в TXT, DOCX, PDF или в субтитры SRT и VTT – последнее удобно, если текстовая версия нужна прямо на плеере. Краткое саммари AudioVText собирает сам, по нему быстро понятно, о чём ролик.
Начните со следующего скринкаста. Запишите его как обычно, расшифруйте и потратьте двадцать минут на текстовую версию. Если через месяц коллега найдёт инструкцию поиском, а не вопросом в чат, схема работает.


Комментарии