
В браузере сайт выглядит полным: цены, описание услуг, контакты. А ChatGPT на вопрос о вашей компании отвечает общими словами или подставляет чужие данные. Одну из причин можно проверить своими руками. Почти все ИИ-краулеры, то есть боты, которые обходят сайты для нейросетей, забирают страницу без запуска JavaScript. Это код, который браузер выполняет уже после загрузки страницы. Если текст появляется только после этого кода, бот получает почти пустой каркас, и цен с контактами для нейросети на сайте просто нет.
После проверки вы будете знать, какие ИИ-боты заходят на сайт, что они получают в ответ и что поменять на сервере, если получают пустую страницу. Понадобятся:
- доступ к логам: через панель хостинга или к самому серверу через удалённый терминал;
- команды grep и curl: на сервере и в терминале компьютера они обычно уже есть;
- адрес страницы, где важен текст: цены, услуги, контакты.
Почему ИИ-краулеров не видно в Google Analytics и Яндекс Метрике
Счётчики аналитики работают на JavaScript, а боты скрипты не выполняют, поэтому в отчётах их нет. Судить о том, что знает о сайте нейросеть, по аналитике и по виду страницы в браузере нельзя: смотреть нужно в логи сервера и в HTML, который сервер отдаёт без скриптов. Если важный текст, цены или контакты появляются на странице только после работы JavaScript, для ИИ-сервисов их нет. Исправляется это тем, что сервер сразу отдаёт готовую страницу (серверный рендеринг или пререндеринг), а не правкой robots.txt (файла с правилами для ботов).
Аналитика к тому же отсекает ботов сама. Google Analytics 4 автоматически исключает трафик известных ботов. Отключить это нельзя, и даже посмотреть, сколько ботов отсеяно, тоже нельзя. В Яндекс Метрике счётчик состоит из JS-кода и картинки на случай выключенных скриптов, а визит без JS и без заголовка Referer (он сообщает, с какой страницы пришёл посетитель) Метрика считает роботом.
Лог сервера от скриптов не зависит. Веб-сервер дописывает в файл строку на каждый запрос, кто бы его ни прислал: браузер, поисковый робот или бот нейросети. Поэтому ботов ищут в логах сервера.
Боты ChatGPT и Claude скачивают скрипты, но не запускают их
Боты ChatGPT и Claude скачивают JS-файлы, но не выполняют их, поэтому видят только тот HTML, который сервер отдал сразу. Сильнее всего это бьёт по одностраничным приложениям (SPA) на React и Vue, где весь сайт работает как одна страница, и по конструкторам, которые собирают страницу скриптами. Сервер отдаёт почти пустой HTML и скрипт, а заголовки, цены и текст в него вставляет уже браузер.
По исследованию Vercel и MERJ, ни один из крупных ИИ-краулеров не рендерит JavaScript, то есть не выполняет скрипты, чтобы собрать итоговую страницу. Исследователи несколько месяцев смотрели логи nextjs.org и сети Vercel, результаты вышли в декабре 2024 года. Вывод касается и всех трёх ботов OpenAI. Вот тут и прикол: скрипты они при этом скачивают. На JS-файлы пришлось 11,50% запросов бота ChatGPT и 23,84% запросов бота Claude, у Claude это почти каждый четвёртый запрос. Файл боты забрали, но не запустили, и текст, собранный в браузере, до них не дошёл.
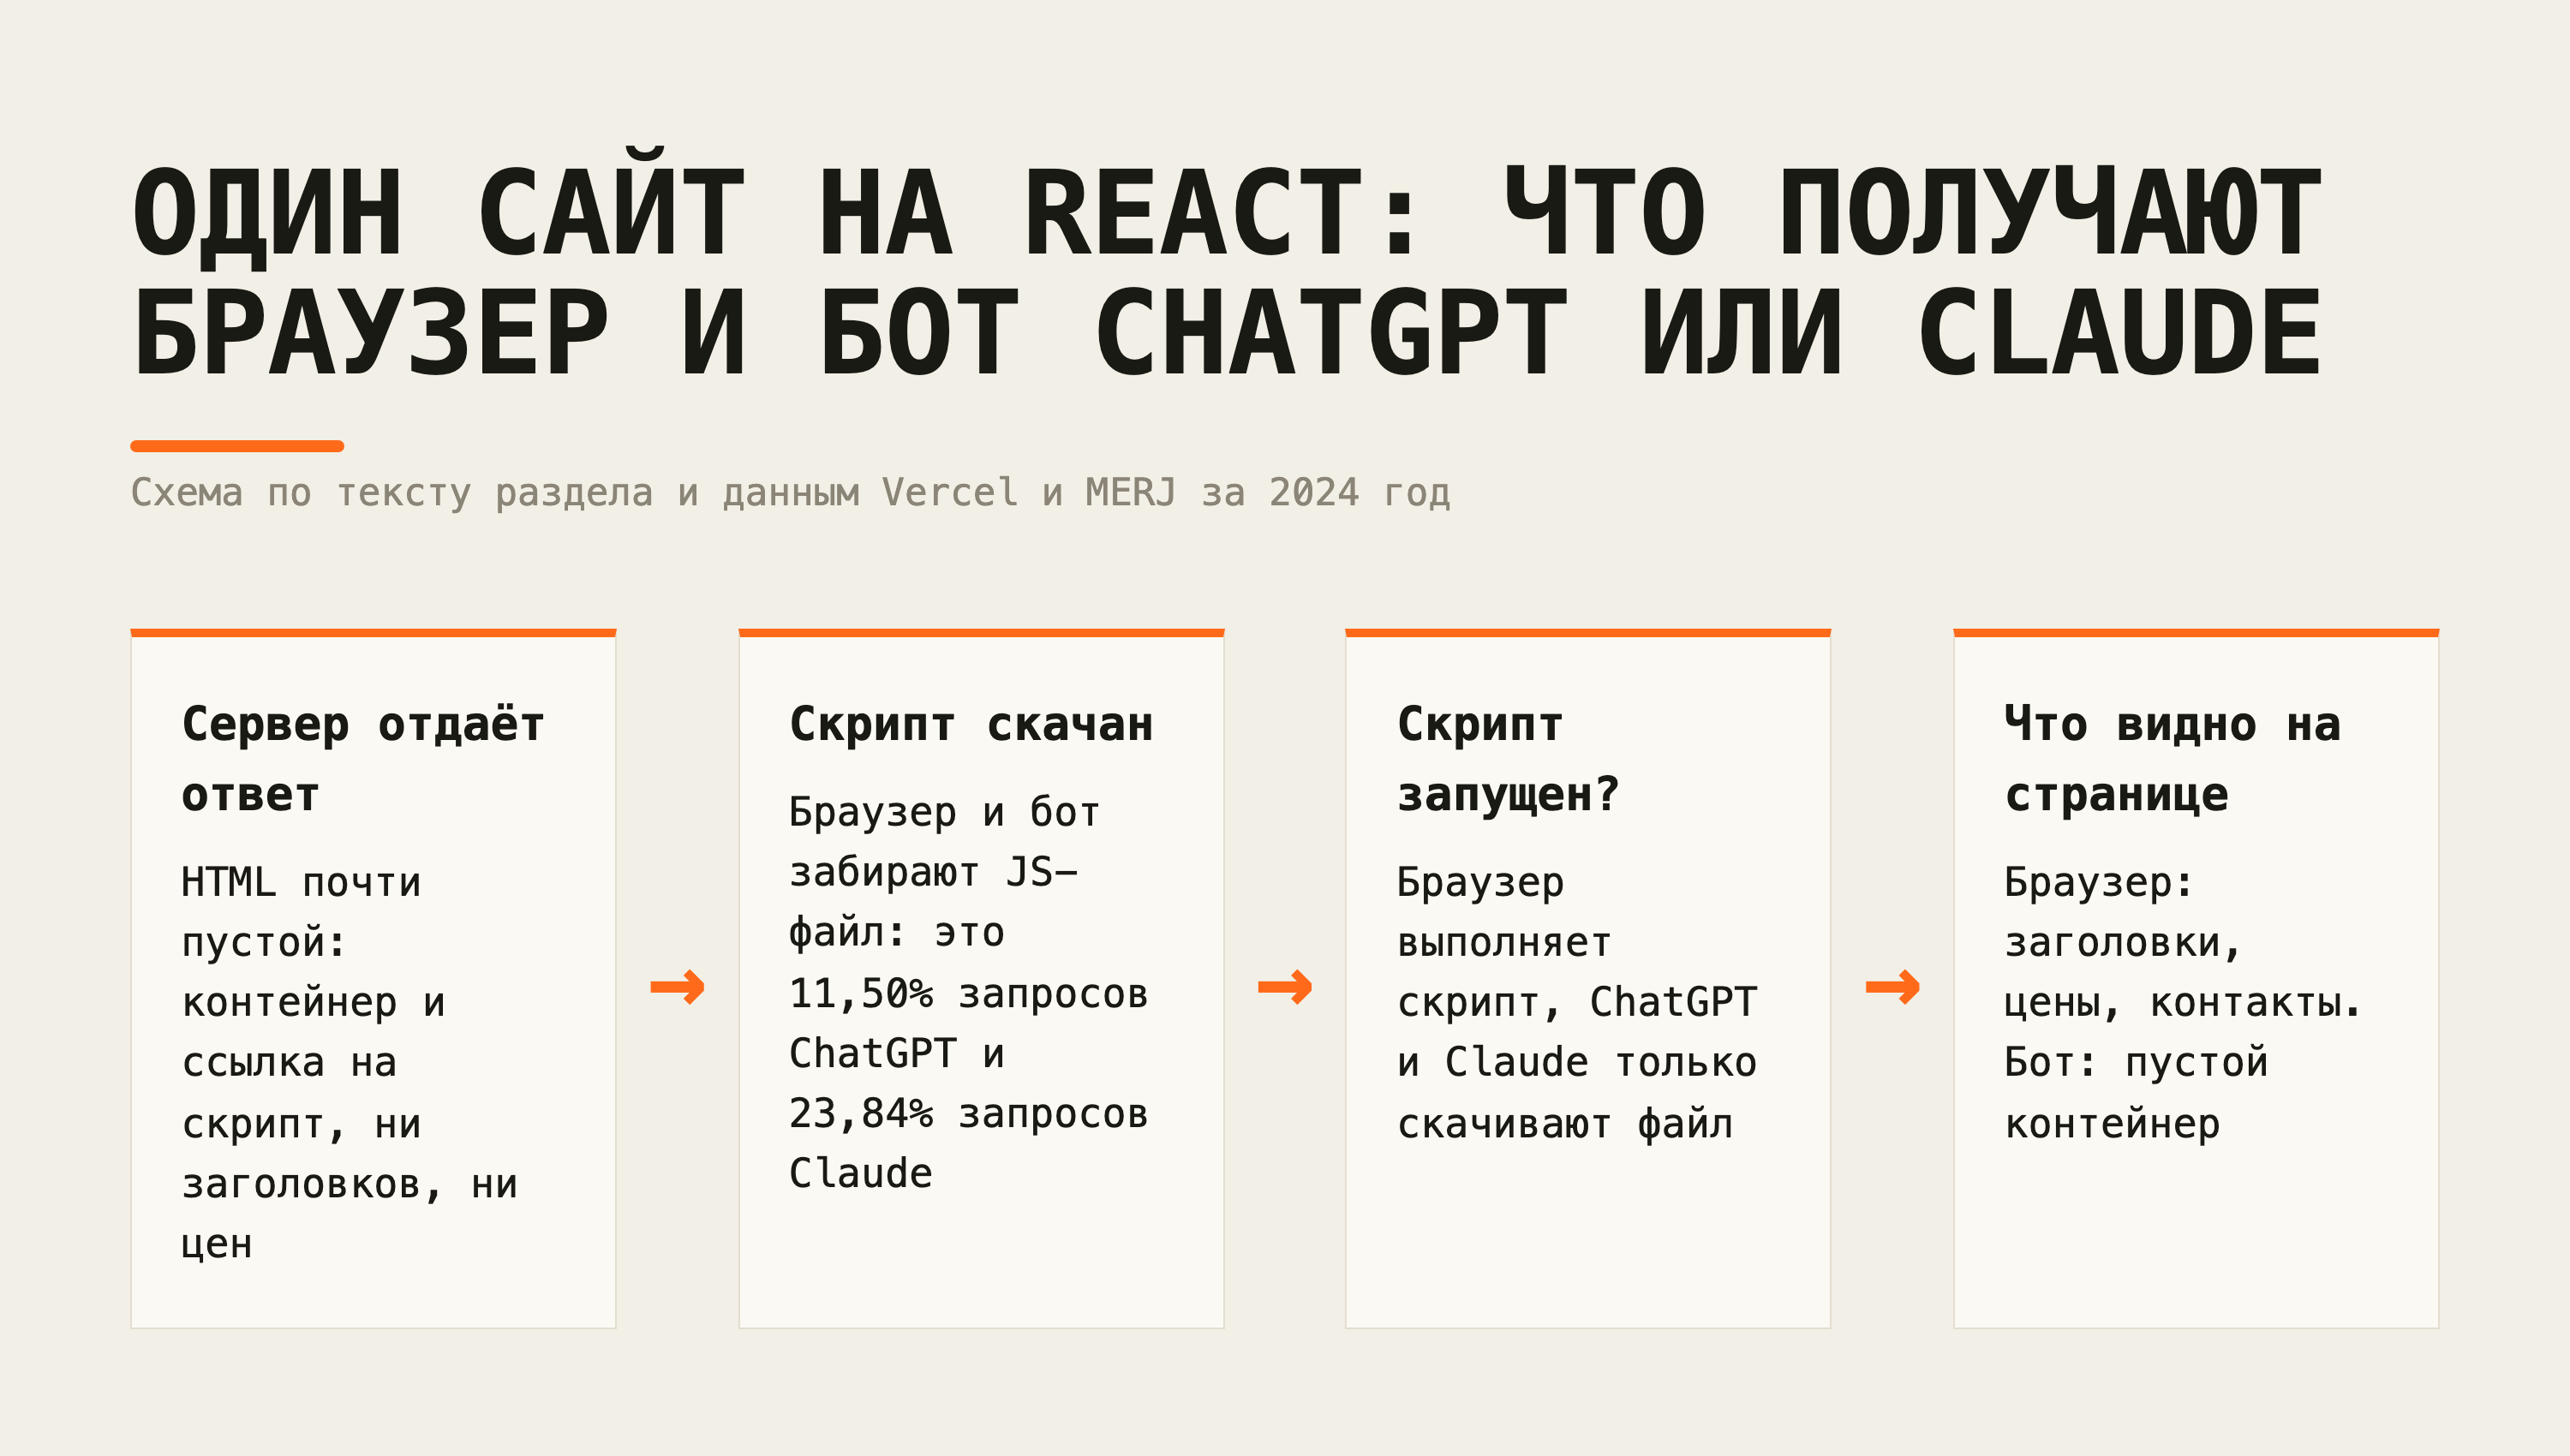
Обе дорожки совпадают до третьего шага, и только там бот теряет текст. Изображение: автор статьи
Исключения есть. Gemini работает на инфраструктуре Googlebot и выполняет JavaScript полностью, AppleBot тоже запускает скрипты через браузерный краулер. В небольшом тесте Search Engine World (июнь 2026, в пересказе liamvi.com) на страницу поставили два числа: одно стояло прямо в HTML, второе записывал скрипт. ChatGPT, Claude, Perplexity и Copilot назвали число из HTML, а DeepSeek, ERNIE, Qwen, Kimi и Mistral – то, что записал скрипт. Каждому ассистенту задали вопрос один раз, так что это только ориентир. Для сайта это значит, что текст, который вставляет скрипт, для ChatGPT и Claude лучше считать невидимым.
Какие ИИ-краулеры приходят за обучением модели, а какие за поиском и по запросу пользователя
У каждого сервиса несколько ботов, и приходят они за разным. Одни собирают тексты для обучения модели, другие нужны для поиска, третьи открывают страницу, когда пользователь сам попросил. В логах их различают по user-agent, строке, которой клиент представляется серверу. Например, по user agent GPTBot видно бота OpenAI, который собирает тексты для обучения.
| Бот | Компания | Зачем приходит |
|---|---|---|
| GPTBot | OpenAI | собирает тексты для обучения моделей |
| OAI-SearchBot | OpenAI | нужен для показа сайта в поиске ChatGPT |
| ChatGPT-User | OpenAI | открывает страницу по запросу пользователя, сам сеть не обходит |
| ClaudeBot | Anthropic | собирает тексты, которые могут пойти на обучение моделей |
| Claude-User, Claude-SearchBot | Anthropic | отдельные от ClaudeBot боты |
| Google-Extended | токен для robots.txt, отдельной строки user-agent в логах у него нет |
robots.txt – текстовый файл в корне сайта, где владелец пишет, каким ботам что можно. Боты OpenAI управляются в нём независимо. Чтобы сайт показывался в поиске ChatGPT, но тексты не шли на обучение, разрешают OAI-SearchBot и закрывают GPTBot:
User-agent: OAI-SearchBot
Allow: /

User-agent: GPTBot
Disallow: /
ChatGPT-User ходит по просьбе пользователя, поэтому правила robots.txt к нему могут не применяться. Anthropic не советует блокировать свои боты по IP: тогда ClaudeBot не сможет прочитать robots.txt. С 30 октября 2026 года Anthropic учитывает ещё и новый машиночитаемый сигнал, которым владелец сайта запрещает обучение на своих текстах. Если в robots.txt есть правило, где ClaudeBot назван явно, главнее оно.
Для ответов Алисы AI в поиске Яндекса есть отдельный токен robots.txt. Он действует на страницы, которые уже проиндексировал основной робот, и сам ничего не индексирует. Выполнять ли JavaScript, робот Яндекса решает сам. Про ботов GigaChat публичных данных нет, поэтому в командах ниже его нет. Для Perplexity в командах стоит просто слово perplexity: grep найдёт любую строку, где оно есть в user-agent.
Где найти логи сервера и как включить запись в access.log
Лог доступа (access.log) – это файл, куда веб-сервер дописывает строку на каждый запрос. На виртуальном хостинге запись логов обычно выключена. В панели Timeweb её включают во вкладке Логи: выбирают сайт и включают ползунок Лог доступа (access_log). Так панель описана в блоге Timeweb в 2017 году, сейчас раздел может выглядеть иначе, а у другого хостинга и называться по-другому. Если запись была выключена, прошлых визитов ботов в логе не будет: только запросы после включения.
На своём сервере с nginx путь к логу и формат записи задаёт директива access_log. Найти её можно так:
grep -r access_log /etc/nginx/
Команда ищет слово access_log во всех файлах настроек nginx и выводит строки с путём к логу. Если директивы нет или запись в ней отключена, впишите в блок server строку access_log /путь/к/access.log combined;, где вместо /путь/к/access.log подставьте путь к файлу лога, а затем попросите nginx заново прочитать настройки. В nginx заранее определён формат combined: в записи есть IP, время, запрос, статус ответа и user-agent. Условная строка выглядит так:
203.0.113.25 - - [09/Nov/2026:10:15:42 +0300] \"GET /prices HTTP/1.1\" 200 5120 \"-\" \"Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko); compatible; GPTBot/1.2; +https://openai.com/gptbot\"
Здесь 203.0.113.25 – адрес клиента, GET /prices – запрошенная страница, 5120 – размер ответа в байтах, в конце стоит user-agent. Число 200 – HTTP-статус, то есть код ответа сервера: 200 значит, что страница отдана, 404 – не найдена, 403 – доступ закрыт.
Работает ли лог, проверяет команда tail -n 3 access.log: она выводит три последние строки файла. Вводите её в терминале на сервере или на своём компьютере, если скачали лог из панели; вместо access.log подставьте полный путь к найденному или скачанному файлу. Откройте сайт в браузере и запустите её. Если вашего визита в выводе нет, лог выключен или вы смотрите не тот файл.
Как найти GPTBot в логах сервера и проверить, просил ли он скрипты
GPTBot в логах находит команда grep: она выводит строки файла, где встречается заданное слово. Ключ -i велит не различать заглавные и строчные буквы.
grep -i 'GPTBot' access.log
Если вывод пустой, значит, лог включили недавно, бот ещё не приходил или файл не тот. Всех ботов из таблицы можно найти сразу и посчитать их визиты, если перечислить имена через вертикальную черту:
grep -E -i -o 'GPTBot|OAI-SearchBot|ChatGPT-User|ClaudeBot|Claude-User|Claude-SearchBot|perplexity' access.log | sort | uniq -c | sort -rn
Ключ -E разрешает такой список, -o оставляет в выводе только найденное имя, sort и uniq -c считают повторы. Вывод выглядит так, цифры условные:
  42 GPTBot
  17 ClaudeBot
   5 ChatGPT-User
Старые логи часто лежат сжатыми в архивах .gz, их читает zgrep:
zgrep -h -i 'GPTBot' access.log.*.gz
Какие страницы забирает бот и что получает в ответ, покажет такая команда:
grep -i 'GPTBot' access.log | awk '{print $9, $7}' | sort | uniq -c | sort -rn | head -20
awk вынимает из строки нужные поля: седьмое – адрес страницы, девятое – статус. Если на важные страницы бот получает 403 или 404, дело не в JavaScript. Бота не пускают или страницы нет.
Дальше главная проверка: просил ли бот скрипты.
grep -i 'GPTBot' access.log | grep -E '\.js( |\?)'
Чтобы выполнить внешний скрипт, его сначала нужно скачать. Пустой вывод значит, что внешних скриптов бот не запрашивал, а значит, не мог их и запустить. Обратное ничего не доказывает: в логе видно, что скрипт скачали, но не видно, запустили ли его. В логе одного новостного сайта за 30 дней (Forge Creative, 24 сентября 2026, в пересказе liamvi.com) ChatGPT-User не запросил ни одного скрипта на 37 045 страниц. Внушительная пустота.
Если строки читать неудобно, GoAccess соберёт из них отчёт. Он разбирает combined-логи, в том числе сжатые .gz, а в документации есть пример, как отобрать ботов через grep:
grep -E -i 'GPTBot|OAI-SearchBot|ChatGPT-User|ClaudeBot|Claude-User|Claude-SearchBot|perplexity' access.log | goaccess - --log-format=COMBINED
Как открыть страницу сайта так, как её получает GPTBot
Страницу глазами бота показывает команда curl с user-agent бота. Она получает тот же сырой ответ сервера, что и боты без JavaScript. curl – программа, которая отправляет запрос и печатает ответ, ничего не запуская.
curl -s -A 'Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko); compatible; GPTBot/1.2; +https://openai.com/gptbot' https://example.com/prices -o bot.html -w '%{http_code}\n'
Ключ -A задаёт user-agent, -s убирает индикатор загрузки, -o сохраняет ответ в файл bot.html, а -w печатает в терминале HTTP-статус: 200 значит, что страница отдана, 403 – что запрос не пустили. Строка user-agent здесь условная, с именем бота внутри. Для Claude подставьте в неё ClaudeBot.
Теперь сравните с браузером. Откройте ту же страницу, возьмите фразу, которую видно на экране, например заголовок, цену или телефон, и найдите её в файле:
grep -c 'Тарифы' bot.html
Ключ -c выводит число строк, где есть эта фраза. Для второй проверки откройте в браузере адрес страницы, перед которым дописано view-source:. Так браузер показывает HTML до работы скриптов. Обычно он совпадает с bot.html, если сервер не отдаёт ботам отдельную версию. Инспектор элементов в браузере для этой проверки не годится: в нём уже результат работы скриптов.
Результат читается так:
- Число больше нуля: текст есть в HTML, бот его получает.
- Ноль, а в файле почти пустой контейнер div, например с id root, и строки подключения скриптов: текст собирает JavaScript, для ИИ-бота его на странице нет.
- Статус 403 или заглушка вместо страницы: защита сайта или хостинга не пустила запрос. Тогда смотрите в логе, какие статусы получал настоящий бот.
Как отличить настоящего GPTBot от скрипта, который подписался его именем
Назваться GPTBot может любой скрипт, поэтому одного user-agent мало: адрес из лога сверяют с адресами, которые опубликовала компания. У каждого бота OpenAI есть свой JSON-файл со списком IP, например gptbot.json, ссылки на них собраны на странице документации. Anthropic тоже публикует список адресов своих краулеров.
Возьмите IP из строки с GPTBot и найдите его в списке. Если в списке диапазоны адресов с косой чертой, вставьте свой IP и диапазон в онлайн-калькулятор подсетей: он покажет, входит ли адрес в диапазон. Перебирайте диапазоны из файла, пока не найдёте тот, в который адрес входит. Адрес вне списка значит, что приходил кто-то другой под именем бота OpenAI. Как автоматизировать такую сверку и держать список адресов актуальным, я разбирал в статье о том, как пустить ИИ-ботов на сайт и не пустить тех, кто ими притворяется.
Яндекс списка IP не публикует. Его роботов проверяют обратным запросом имени по адресу (reverse DNS): у настоящих роботов имя заканчивается на yandex.ru, yandex.net или yandex.com.
host 203.0.113.25
Команда выводит имя сервера для этого адреса. Если имя кончается иначе, под Яндекс маскируется кто-то другой.
Как отдать ИИ-краулерам готовую страницу: серверный рендеринг или пререндеринг
Страницу нужно собирать на сервере: тогда бот сразу получит готовый HTML с текстом. Vercel советует рендерить важный контент на сервере, потому что ChatGPT и Claude скрипты не выполняют. Способов два:
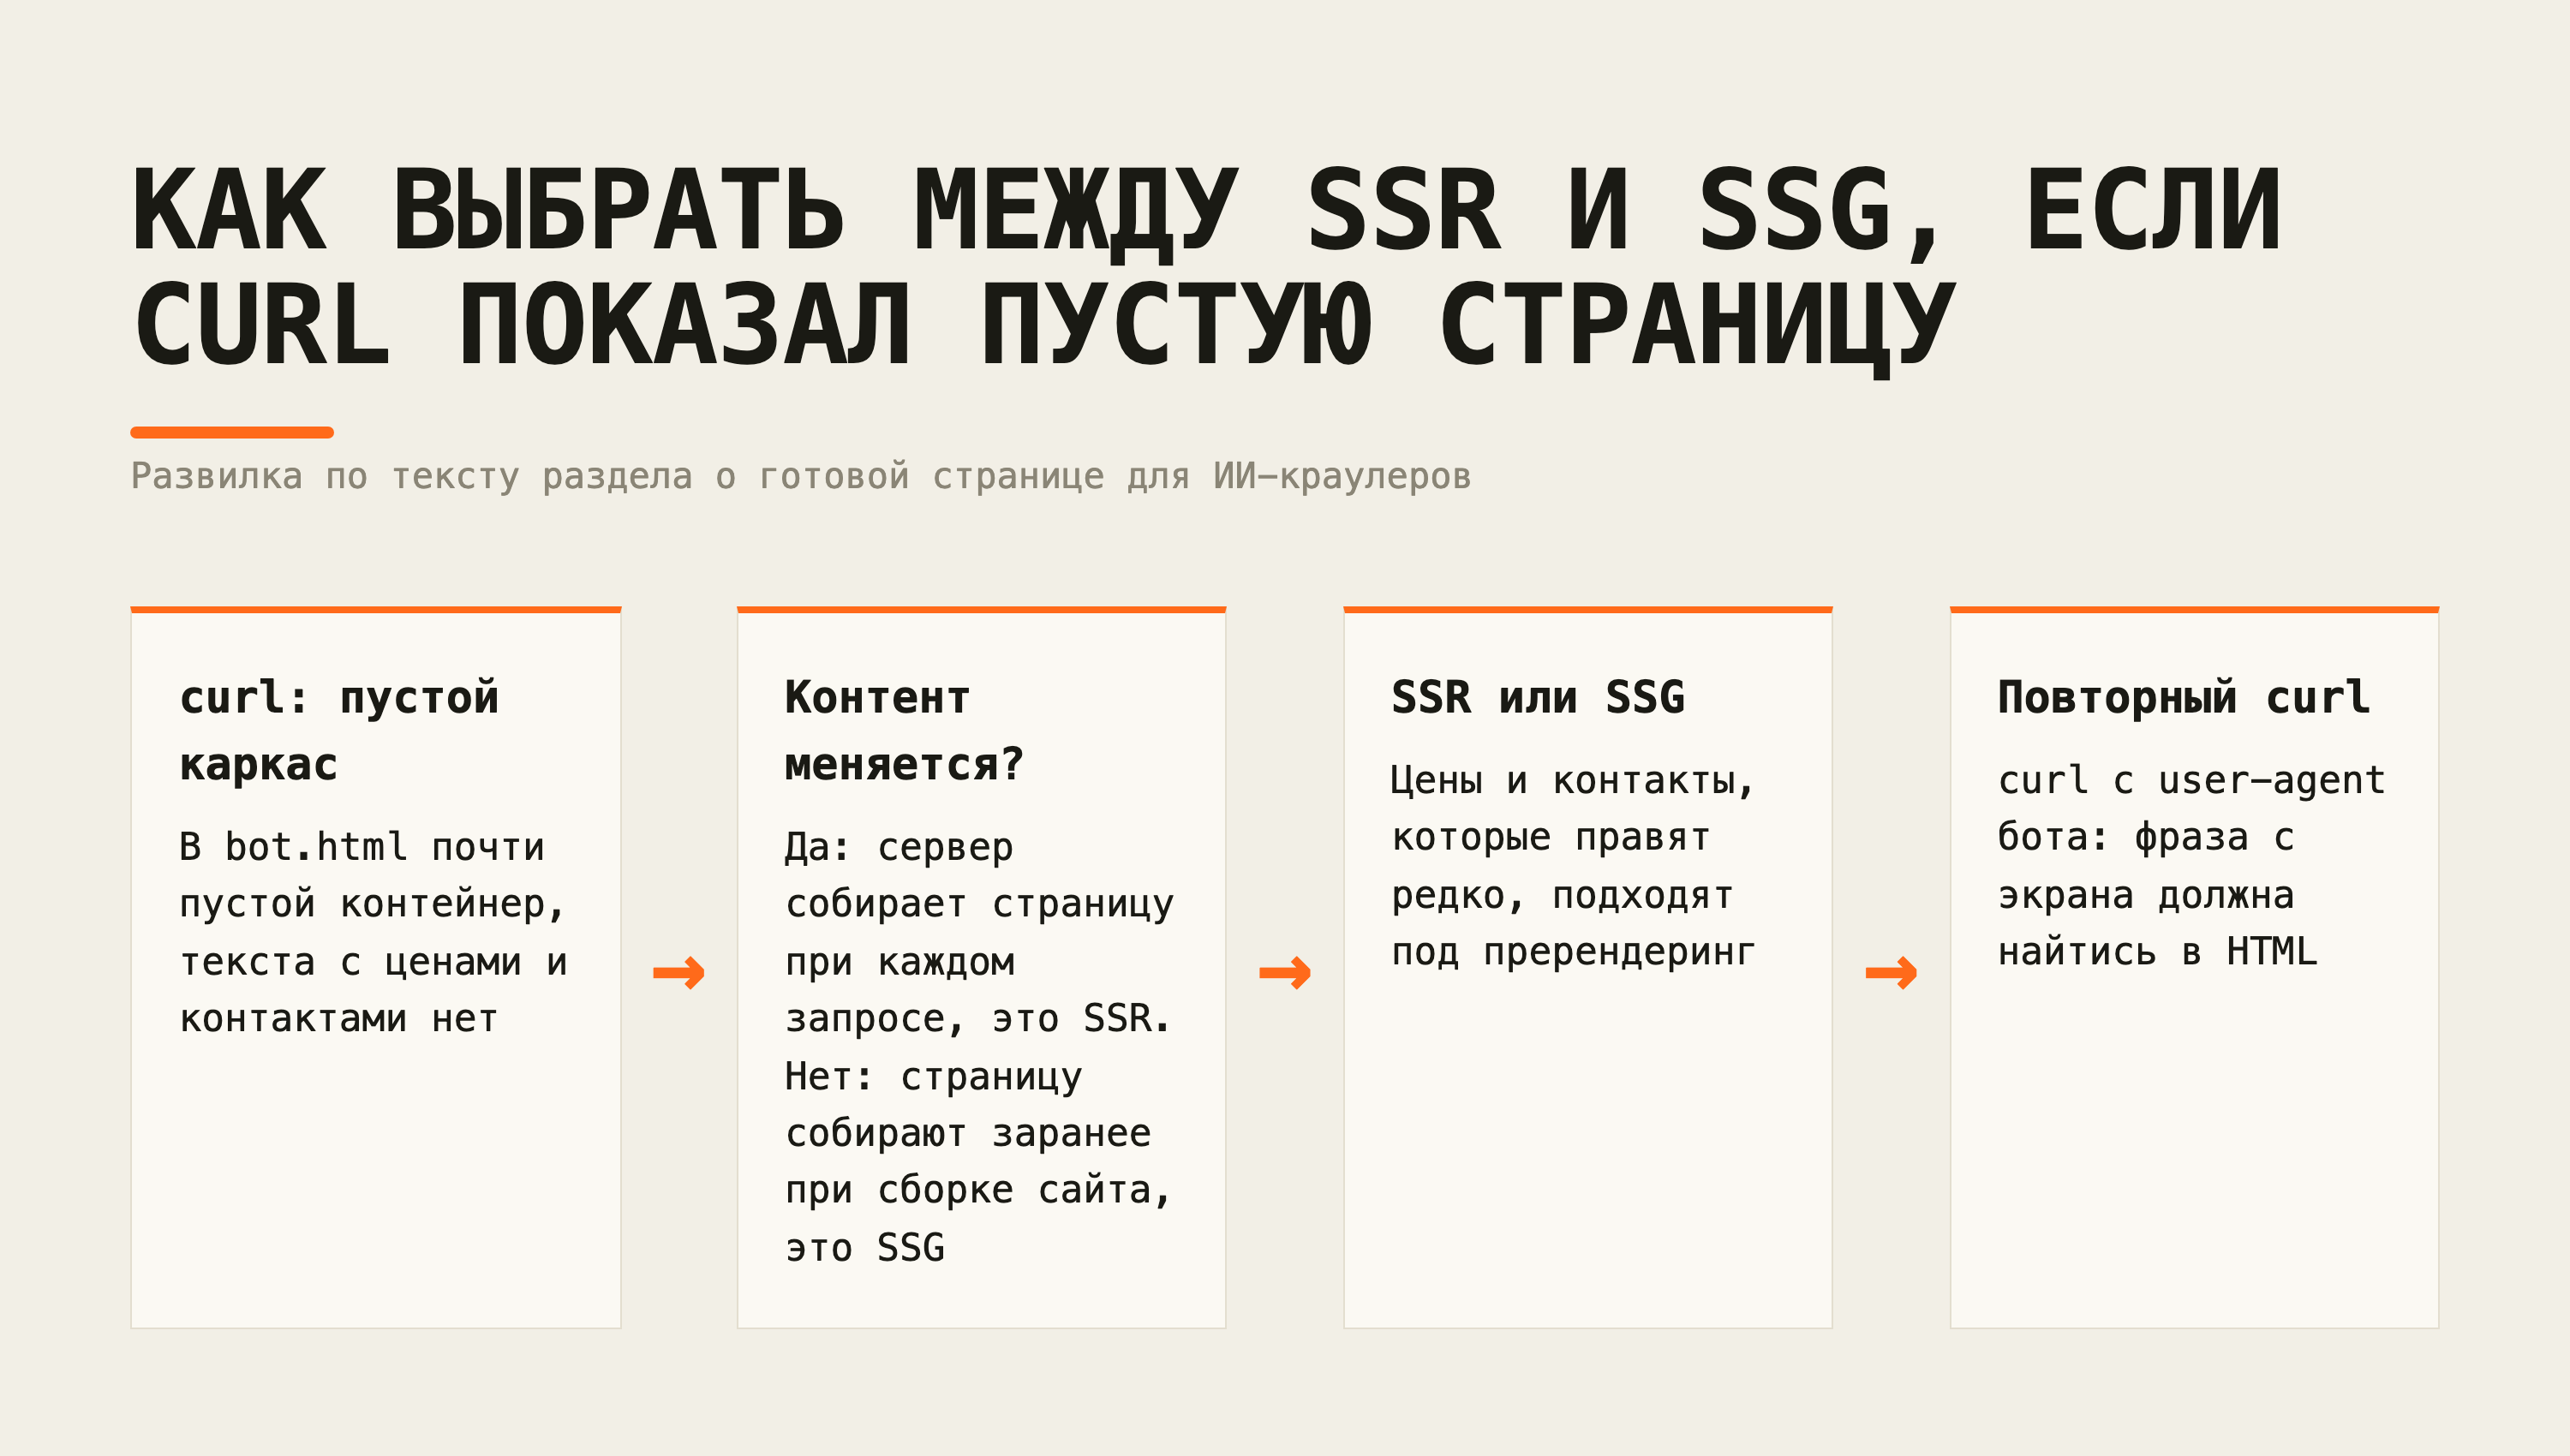
Выбор способа зависит от одного вопроса на втором шаге, а curl служит и входом, и проверкой результата. Изображение: автор статьи
- Серверный рендеринг (SSR). Сервер собирает страницу заново при каждом запросе.
- Пререндеринг (SSG). Страницу собирают заранее, при сборке сайта, и отдают готовым HTML-файлом. По документации Vue он подходит для данных, которые не меняются между запросами. Цены и контакты, которые правят редко, как раз такие.
Если сайт на Vue открывается со спиннером, а содержимое подгружается уже в браузере, краулер ждать не будет, и тут может понадобиться SSR. В Next.js страницы и общие шаблоны (layout) по умолчанию – Server Components, то есть их собирает сервер. Но умолчание легко поменять в коде, поэтому результат всё равно проверяйте командой curl. Если сайт на конструкторе, код не поправить: покажите поддержке вывод curl и спросите, может ли конструктор отдавать страницу уже собранной.
Когда сайт уже отдаёт готовый HTML, в Вебмастере Яндекса для таких страниц рекомендуют запретить рендеринг JavaScript. По умолчанию там стоит опция На усмотрение робота Яндекса.
Как проверить правку: повторите curl с user-agent бота, и фраза должна найтись в bot.html. После следующих визитов ботов посмотрите в логе, что на эти страницы они получают статус 200.
Типичные ошибки: искать ботов в аналитике и смотреть страницу в инспекторе браузера
- Смотреть страницу в инспекторе элементов браузера. Там уже результат работы скриптов, а бот получает другое.
- Искать ИИ-ботов в Google Analytics или Метрике. GA4 известных ботов отсекает сам, Метрика визит без JavaScript относит к роботам.
- Верить user-agent без сверки IP. Назваться GPTBot может любой скрипт.
- Блокировать ClaudeBot по IP. Anthropic предупреждает, что тогда бот не прочитает robots.txt.
- Открыть ботам доступ в robots.txt и ждать. Если HTML пустой, бот с доступом заберёт ту же пустую страницу.
- Включить лог и сразу искать ботов. В логе только запросы после включения, первых визитов придётся подождать.
Значит ли визит бота в логах, что ChatGPT или Claude знает ваш сайт
Нет. Визит бота и готовый HTML значат лишь, что страницу можно было забрать. Vercel заметил, что после вопросов к ChatGPT или Claude о свежей документации Next.js в логах nextjs.org часто нет немедленных обращений: модели могут отвечать по кэшу или по обучающим данным. Пустой лог не значит, что нейросеть сайт не знает. Визит бота тоже не значит, что знает.
Сами компании не пишут, выполняют ли их краулеры JavaScript. Единственное заявление Anthropic касается web fetch, инструмента для разработчиков в API: он пока не поддерживает сайты, собранные на JavaScript. Про ClaudeBot такого заявления нет. Данные Vercel и MERJ собраны к декабрю 2024 года. Сентябрьский отчёт 2026 года по логам одного сайта утверждает, что краулеры OpenAI начали выполнять JavaScript, но OpenAI этого не подтвердила.
Gemini и AppleBot скрипты запускают, и для них картина может быть полнее. Для ChatGPT и Claude, пока подтверждения нет, я исхожу из того, что бот получает только HTML: чего нет в ответе сервера, того для нейросети на сайте нет.
Изображение на обложке: автор статьи
Комментарии