

Wordstat хорошо отвечает на вопрос, какие формулировки встречаются в поиске и сколько запросов с ними зафиксировано в выбранных условиях. Но сервис не отвечает на другой вопрос: стоит ли под каждую найденную формулировку создавать отдельную страницу.
На практике эти две задачи легко смешать. Большое число рядом с широким запросом воспринимается как готовая оценка спроса, список связанных фраз – как почти готовая структура сайта, а длинный низкочастотный запрос – как повод немедленно писать отдельную статью. Ошибка обычно возникает не в данных Wordstat, а в выводе, который делается из них слишком рано.
Ниже разобран подход, при котором поисковая статистика используется не как генератор новых URL, а как способ проверить, существует ли самостоятельная пользовательская задача. В качестве наглядного примера взят реальный массив по MODX: одно короткое слово одновременно вывело CMS, Yamaha, музыкальное оборудование и десятки формулировок, смысл которых нельзя было надёжно определить без дополнительного контекста.
Официальная справка Яндекса описывает Wordstat как инструмент статистики поисковых запросов. В «Топах запросов» сервис показывает популярные запросы, содержащие заданную фразу, и похожие запросы; данные можно фильтровать по региону и типу устройства. Формулировка здесь важна: речь идёт о числе запросов, а не о числе уникальных людей и не о прогнозе трафика на будущую страницу.
Сначала нужно понять, что именно посчитано
В ручном исследовании запрос `modx` показал значение 8 011. Если воспринимать эту цифру без контекста, вывод напрашивается сам: у MODX CMS заметный поисковый спрос, а значит внутри широкого запроса должно быть много подходящих тем для технического контента.
После раскрытия выдачи Wordstat стало видно 324 строки. Для этого среза были сохранены условия измерения: все регионы, десктопы, смартфоны и планшеты, период 05.08.2026-03.09.2026. Уже на первом уровне оказалось, что слово MODX не принадлежит одной предметной области.
| НАБЛЮДЕНИЕ | ЗНАЧЕНИЕ |
| Строк в раскрытом списке `modx` | 324 |
| Явно Yamaha / музыка | 56 |
| Неоднозначные формулировки | 71 |
| Значение широкого `modx` | 8011 |
Среди строк находились `yamaha modx`, `modx синтезатор`, `yamaha modx editor`, названия моделей и запросы о покупке музыкального оборудования. Это не ошибка сервиса: Yamaha использует MODX как название линейки музыкальных рабочих станций, поэтому одинаковая строка закономерно объединяет разные интересы.
Практический вывод отсюда простой: высокая частотность широкого слова ещё не описывает размер конкретной темы. Сначала нужно увидеть состав выдачи, а уже потом оценивать, какая часть данных относится к нужному предмету.
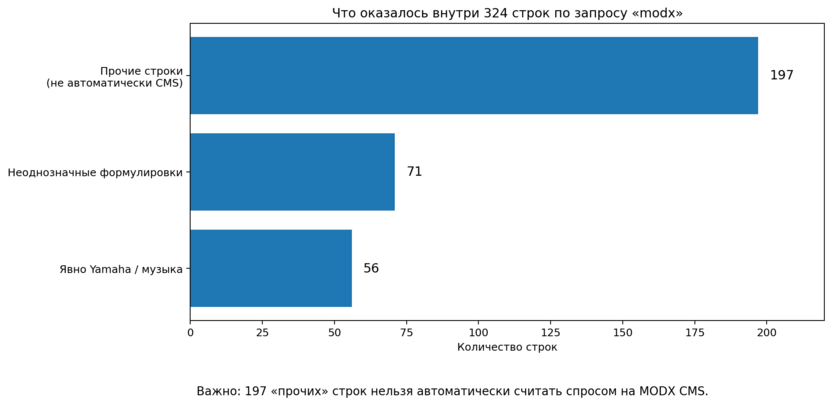 Иллюстрация 1. После отделения явного шума остаток нельзя автоматически считать спросом на MODX CMS
Нерелевантный запрос и неоднозначный запрос – не одно и то же
Строку `yamaha modx` можно уверенно исключить из исследования спроса на CMS. Её смысл понятен, просто он не относится к нужной задаче.
С короткими формулировками ситуация сложнее. В исходных данных встречались `modx m6`, `modx 7`, `modx купить`, `modx цена`, `modx pl` и другие сочетания, для которых одна строка не позволяла надёжно определить смысл. Они могли относиться к модели устройства, версии продукта, покупке, CMS или другому контексту.
Именно поэтому 71 строка была оставлена неоднозначной. Это не «грязные данные», которые обязательно нужно дожать до красивой классификации. Иногда отсутствие достаточного контекста и есть точное описание состояния данных.
Для практической работы полезно разделять как минимум три состояния:
- релевантно – смысл запроса достаточно ясен и относится к исследуемой задаче;
- нерелевантно – смысл достаточно ясен, но относится к другой задаче или продукту;
- неоднозначно – имеющихся данных недостаточно для уверенной классификации.
Такой подход выглядит менее аккуратно, чем таблица, где каждой строке обязательно присвоена категория. Зато он защищает от ситуации, когда предположение аналитика незаметно превращается в «факт» о спросе.
После удаления шума нельзя объявлять остаток спросом на нужную тему
После классификации легко сделать ещё один шаг: 324 строки минус 56 музыкальных минус 71 неоднозначная. Получается 197. Математика корректна, но вывод «197 строк относятся к MODX CMS» из неё не следует.
Причина в том, что исключение двух известных классов ничего не доказывает о природе всех остальных строк. В остатке могут быть брендовые, товарные, служебные, навигационные и другие значения, которые ещё не проверены.
В исходном исследовании поэтому не использовалось правило «не Yamaha = CMS». Релевантность фиксировалась отдельно по веткам. Такой отказ от автоматического присвоения остатка нужной категории особенно важен в семантике: иначе очистка шума превращается в способ искусственно увеличить подтверждённый спрос.
Польза дерева начинается там, где проявляется конкретная задача
После отделения очевидно неподходящих значений внутри MODX появились технические направления, которые уже можно анализировать содержательно. Например:
`ошибка modx` – 45
→ `при вызове formit modx выходит 500 ошибка` – 5
И другая ветка:
`перенос modx` – 32
→ `modx перенос сайта` – 23
Здесь видна принципиальная разница между широким названием области и пользовательской задачей. «Ошибка MODX» обозначает направление. Формулировка про FormIt и HTTP 500 уже описывает наблюдаемый сценарий. «Перенос MODX» задаёт тему, а «перенос сайта» уточняет действие.
Глубина ветки полезна именно этим: помогает перейти от названия технологии к конкретной проблеме или работе. Это не означает, что самая длинная фраза автоматически становится лучшей темой. Она лишь даёт больше информации о намерении пользователя.
Точный низкочастотный запрос не обязан становиться отдельной страницей
Формулировка с частотностью 5 может описывать проблему намного точнее, чем широкая фраза с частотностью 45. Но точность запроса и самостоятельность страницы – разные характеристики.
Перед созданием URL стоит проверить несколько вещей:
- есть ли за запросом отдельная задача, а не частный симптом более широкой проблемы;
- можно ли дать самостоятельный и достаточно полный ответ;
- не отвечает ли на тот же вопрос уже существующая страница;
- будет ли новая страница отличаться по содержанию и диагностике, а не только по ключевой фразе;
- соответствует ли тема реальной услуге, документации или другому полезному результату для посетителя.
Поэтому Wordstat удобнее воспринимать как инструмент обнаружения кандидатов на отдельные задачи, а не как машину по производству новых страниц.
Частотности parent и child нельзя складывать как независимые аудитории
Если `ошибка modx` показывает 45, а вложенная формулировка про FormIt и HTTP 500 – 5, сумма 50 выглядит естественно. Но такая арифметика создаёт число, смысл которого не подтверждён исходными данными.
Связанные запросы внутри дерева могут пересекаться. Wordstat показывает структуру формулировок, а не набор независимых групп людей. По этой причине в исследовании значения parent, child и deeper-веток не складывались.
Это же хорошо видно в другом реальном дереве:
`телеграм бот` – 107 753
→ `телеграм бот заявки` – 185
→ `бот принимает заявки телеграм` – 38
→ `бот который принимает заявки в телеграм канал` – 13
Сумма этих значений мало что объяснит. Зато сама последовательность показывает, как широкая тема постепенно превращается в конкретный сценарий: приём заявки и передача её в канал.
У числа и у структуры ветки разные функции. Число характеризует конкретную формулировку в условиях измерения. Ветка помогает понять, как меняется смысл по мере уточнения запроса.
Нулевое значение не доказывает отсутствие проблемы
Обратная ошибка возникает, когда у технически понятной формулировки Wordstat показывает 0. В отдельных проверках такие результаты встречались у `woocommerce не приходят письма`, `telegram callback не работает`, `tilda webhook ошибка`, `битрикс24 webhook не работает` и других вполне реальных технических сценариев.
Ноль относится к конкретной формулировке и конкретному измерению. Он не означает, что webhook никогда не ломается или что письма WooCommerce всегда доходят. Пользователи могут описывать ту же ситуацию другими словами.
При этом ноль нельзя использовать и как повод проигнорировать данные и написать статью «потому что проблема существует». Корректнее проверить соседние формулировки, поисковую выдачу, текущие материалы сайта и техническую самостоятельность сценария.
Иными словами, ноль уменьшает уверенность в выбранной формулировке, но не решает вопрос о существовании самой задачи.
Практический алгоритм: от Wordstat к решению о странице
Чтобы не превращать статистику запросов в генератор ложной точности, анализ удобно проводить последовательно.
- Зафиксировать условия измерения: период, регион, устройства и источник значения. Цифра без этих параметров плохо сравнима с другим измерением.
- Использовать широкий запрос как вход в предметную область, а не как готовую тему.
- Просмотреть реальные строки в выдаче и отделить явно нерелевантные значения.
- Не принуждать неоднозначные формулировки к классификации, если контекста недостаточно.
- Раскрывать релевантные ветки до тех пор, пока они дают новые реальные формулировки и уточняют задачу.
- Не складывать значения parent и child как независимый спрос.
- Определить поисковое намерение: ремонт, настройка, покупка, обучение, навигация, скачивание или другой сценарий.
- Сравнить найденную задачу с существующими страницами и проверить смысловое пересечение.
- Только после этого выбрать формат: отдельная статья, раздел существующего материала, FAQ или отказ от нового URL.
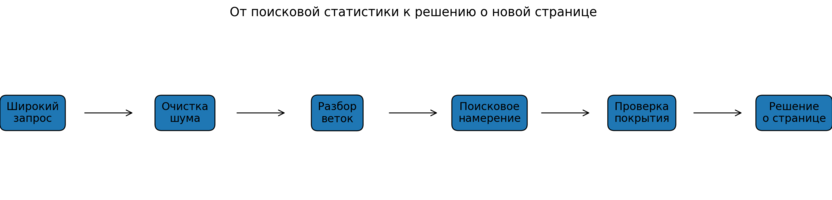
Иллюстрация 2. Рабочая последовательность: от широкого запроса к решению о самостоятельной странице
Иногда сильный результат исследования – не создавать новый материал
У исследования семантики нет обязанности завершаться публикацией.
В MODX-разборе были изучены десятки технических и коммерческих направлений: ошибки, перенос, формы, FormIt, база данных, хостинг, API, шаблоны, админка, поддержка и разработка. Были последовательно открыты 99 заранее зафиксированных родительских запросов, а вместе с найденными дочерними ветками проверено 143 уникальные страницы запросов Wordstat.
При этом в исследовательском логе осталось `Article: NOT CREATED`: отдельная статья не создавалась, публикаций на сайте по результатам этого разбора не было.
Такой исход полезен. Он означает, что данные использованы для проверки гипотез, а не для обязательного оправдания очередной публикации. Если заранее считать, что любой сбор семантики должен закончиться новой страницей, появляется стимул трактовать шум, пограничные формулировки и слабые ветки в пользу контента.
Редакционное решение может быть любым из четырёх: создать отдельный материал, расширить существующий, добавить короткий ответ внутри уже подходящей страницы или ничего не публиковать до появления более сильных оснований.
Где заканчиваются данные Wordstat
Wordstat предоставляет наблюдаемые данные о поисковых формулировках. Он не может автоматически определить, насколько полезной получится будущая статья, будет ли она отличаться от соседней страницы, войдёт ли в индекс поисковой системы и принесёт ли целевой трафик или заказ.
Поэтому частотность не стоит превращать в универсальный рейтинг тем. Она становится полезнее, когда используется вместе с контекстом: поисковым намерением, реальной технической задачей, существующим покрытием сайта и возможностью дать отдельный полноценный ответ.
В таком подходе цель анализа меняется. Вместо максимального количества ключей появляется более практичная задача – сократить количество страниц, созданных на слабых или неверно интерпретированных основаниях.
Что показал MODX-кейс
Запрос `modx` с показателем 8 011 сначала выглядел как крупный пласт интереса к CMS. После раскрытия пришлось проверить 324 строки, отдельно исключить 56 явно музыкальных формулировок, оставить 71 строку без уверенной классификации и затем разбирать CMS-релевантные ветки по отдельности.
Главный результат здесь не в конкретных числах. Он в последовательности проверки: сначала состав данных, потом смысл формулировок, затем поисковое намерение и только после этого решение о структуре сайта.
Чем шире запрос, тем осторожнее нужно относиться к одной большой цифре. Она может быть хорошей отправной точкой для исследования, но редко является готовым ответом на вопрос «какую страницу создать».
Иногда после такого анализа действительно появляется сильная тема. Иногда достаточно доработать существующий материал. А иногда наиболее обоснованный итог – не создавать ещё один URL.
Методика и источники
В основу материала вошли данные авторизованного Яндекс Wordstat и отдельные исследования WebFixer24 за август-сентябрь 2026 года. Основная воспроизводимая выгрузка от 30 августа содержала 623 уникальные формулировки: 620 валидных записей с частотностью и 3 записи с транспортной ошибкой. Для ручных углублённых исследований сохранялись собственные периоды; эти наборы не объединялись в одну статистическую выборку.
Официальная справка на Яндекс Wordstat.
Исследование с методикой, ограничениями и дополнительными примерами на WebFixer24.

Комментарии