
llms.txt – текстовый файл в корне сайта. Он в сжатом виде объясняет ИИ-агенту (программе, которая автоматически читает страницы сайта, а не человеку в браузере), что за проект перед ней и где искать документацию. 10 августа 2026 года формат получил вторую версию спецификации – первую ревизию с момента запуска в сентябре 2024-го. Автор – Джереми Ховард из Answer.AI, текст спецификации лежит на llmstxt.org, список правок второй версии – на отдельной странице изменений.
Пересказывать спецификацию построчно я не стал: это уже сделали до меня, и почти каждый такой разбор ограничивается фразой «вот что написано на llmstxt.org». Вместо этого я взял десяток чужих файлов у крупных компаний и одну референсную реализацию самого автора спецификации, прогнал их прямыми запросами и посмотрел, что из заявленного формата реально долетает до бота, а что существует только на бумаге. У трети проверенных адресов нашёлся дефект: где-то вместо текста отдаётся HTML-страница ошибки, где-то файл ведёт на мёртвую ссылку после переезда документации, где-то один файл ещё недавно дублировал другой под другим именем. Заодно я проверил главную новинку второй версии – механику, которой страница объявляет о своей markdown-копии: на десяти доменах, включая сайт самого автора спецификации, она не включена ни у кого.
Что я проверял и как
Я взял десять адресов: документацию OpenAI, Anthropic, Google Gemini, референсную реализацию формата от самого автора спецификации (FastHTML), Cloudflare, Mistral, Cursor, Сбера, Expo и ElevenLabs. Выбор не случаен: три компании прямо названы в тексте спецификации как публикующие llms.txt для разработчиков, ещё несколько взяты из собственного сентябрьского замера 32 доменов, а Сбер добавлен как крупный российский пример из той же категории – документация для разработчиков.
Метод простой: curl (консольная утилита для отправки HTTP-запросов без браузера) с флагом -sI показывает только заголовки ответа – код статуса, редиректы (переадресации на другой адрес) и Content-Type– служебный заголовок, который сообщает, какого типа данные лежат в файле: обычный текст, markdown-разметка или HTML-страница. Дальше curl -s без флага I забирает само тело файла, чтобы посчитать размер в байтах и, где на сайте есть два похожих файла, сравнить их побайтово через md5sum – алгоритм, который сжимает содержимое в короткий отпечаток: если отпечатки двух файлов совпали, содержимое идентично, даже если имена разные.
curl -sI https://developers.openai.com/llms.txt
Такая команда за секунду показывает главное: жив ли файл вообще, что он отдаёт по существу и сколько раз запрос переадресуется, прежде чем дойти до содержимого. Все проверки в статье сняты 16 сентября 2026 года.
Что показали прямые запросы
Дефект в момент проверки нашёлся у трёх адресов из десяти. Со стороны ни один из них не выглядит сломанным: адрес открывается, браузер что-то показывает, и владелец сайта видит страницу, а не ошибку. Разницу между «файл отдаётся» и «файл есть» показывает только прямой запрос. Ещё два адреса были с дефектом две недели назад, в моём замере от 2 сентября, и к 16 сентября их успели починить. Остальные пять отдают ровно то, что должны: текстовый файл с кодом 200 и правильным типом содержимого.
Отдельного разговора заслуживает developers.cloudflare.com: его llms.txt – не список ссылок на страницы, а оглавление, которое ссылается на отдельный llms.txt каждого продукта. Именно так на практике выглядит механика подпутей, которую спецификация формализовала в августе: когда файлов на сайте несколько, агент берёт самый специфичный из подходящих по пути.
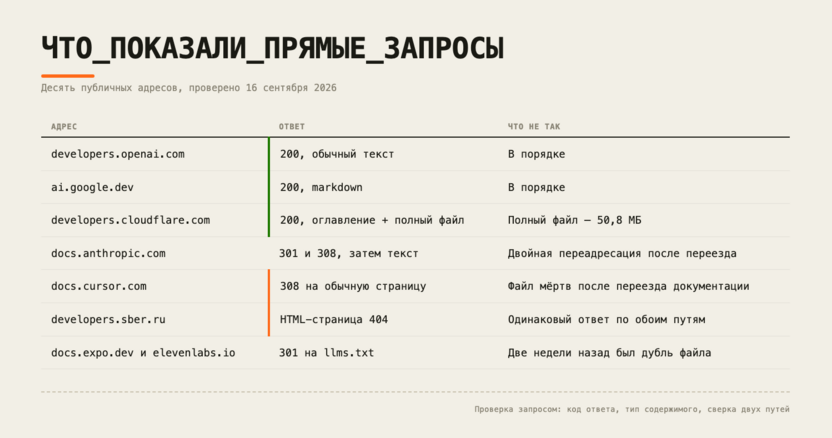
Проверка запросом: у трёх адресов из десяти вместо файла страница, переадресация или общий ответ роутера.
Три способа, которыми файл притворяется существующим
HTML вместо текста – первый способ. На developers.sber.ru оба адреса, /llms.txt и /llms-full.txt, отдают одну и ту же страницу ошибки объёмом 164 483 байта с типом text/htmlФайла в буквальном смысле не существует: отвечает штатный роутер сайта – часть сервера, которая сопоставляет адрес со страницей и на любой незнакомый путь отдаёт свою страницу 404. Проверка по принципу «адрес открывается, значит файл есть» здесь ничего бы не показала – важен именно Content-Type, а не факт открытия страницы.
Мёртвая ссылка после переезда документации – второй способ. На docs.cursor.com/llms.txt стоит редирект с кодом 308, ведущий на cursor.com/docs – обычный HTML-лендинг, а не текстовый файл. Тот же паттерн, только мягче, у старого адреса Anthropic: docs.anthropic.com/llms.txt всё ещё отвечает, но добирается до реального содержимого только через двойной редирект, потому что площадка переехала на Claude Developer Platform. llms.txt в этом смысле ничем не отличается от обычной страницы сайта: миграция документации без обновления файла или его редиректов ломает его так же, как сломала бы карту сайта, только этого никто не замечает, потому что файл никто не открывает руками.
Файл llms-full.txt, дублирующий llms.txt под другим именем, – третий способ. На момент моего сентябрьского замера docs.expo.dev и elevenlabs.io/docs отдавали llms-full.txt, который был побайтовой копией llms.txt: второй файл существовал только на бумаге, реального расширенного содержимого в нём не было. К середине сентября обе площадки заменили дубль прямым редиректом на единственный файл – практика двинулась туда же, куда двинулась спецификация, и это не совпадение: у обоих явлений одна причина, и она в истории самого имени llms-full.txt
Откуда взялся llms-full.txt, которого нет в спецификации
Слова llms-full.txt нет ни в первой, ни во второй версии спецификации – ни как обязательного элемента, ни как опционального. Формат его просто не описывает.
Название прижилось из другого источника. В оригинальном посте Answer.AI за сентябрь 2024 года описывался инструмент llms_txt2ctx, который у референсной реализации формата, фреймворка FastHTML, на выходе давал два файла: llms-ctx.txt без ссылок из секции Optional и llms-ctx-full.txt со всеми ссылками; содержимое ссылок разворачивалось в текст в обоих файлах, разница была только в охвате. Сообщество быстро сократило второе имя до llms-full.txt, и оно стало неформальным стандартом раньше, чем формальным. Во второй версии спецификации сам инструмент убран целиком – то есть даже эта косвенная опора исчезла, а практика с отдельным вторым файлом живёт исключительно как конвенция сторонних генераторов: плагинов для систем управления сайтом, сервисов вроде Firecrawl, части конфигураций платформы Mintlify.
Вес этой практики я оценил по собственному замеру 2 сентября 2026 года на 32 доменах: llms.txt нашёлся у 23 из них, второй файл – у 19. У двух доменов из этих 19, тех же docs.expo.dev и elevenlabs.io/docs, оба файла тогда совпадали побайтово. Там, где файлы всё же были разными по содержанию, разница выходила немаленькой: медиана размера полного файла по 16 самостоятельным, не задублированным слепкам – 715 786 токенов (единица измерения объёма текста для языковых моделей, примерно ¾ слова на токен в русском и английском тексте). Максимум нашёлся у developers.cloudflare.com – по замеру 2 сентября это 12 536 195 токенов, 54,3 мегабайта. При прямой проверке 16 сентября llms-full.txt того же домена весил 50 820 095 байт с типом text/markdown и остаётся крупнейшим найденным файлом такого рода с большим отрывом от всех остальных.
Что реально изменилось в спецификации 10 августа
Главное изменение – формальный способ находить markdown-копию страницы, и я специально проверил, работает ли он хоть где-то. Спецификация вводит два Link-заголовка (служебные HTTP-заголовки ответа сервера, а не видимая ссылка на странице): Link: <url>; rel="alternate"; type="text/markdown" указывает на markdown-версию текущей страницы, Link: <url>; rel="describedby" – на llms.txt, который эту страницу описывает. Каждый можно отдать и HTML-тегом <link> в <head> страницы, и HTTP-заголовком ответа. Второй вариант удобнее: он настраивается на уровне сервера или CDN (сети серверов, которые раздают сайт и умеют добавлять заголовки к ответу без изменения самих страниц) одной строкой конфигурации, сразу для всех страниц сайта.
curl -sI https://www.fastht.ml/docs/ | grep -i '^link:'
Команда печатает только строки заголовка Link; пустой вывод означает, что таких строк в ответе нет (если сомневаетесь, что страница вообще открылась, уберите grep и посмотрите код ответа целиком). Ни на одном из десяти проверенных доменов, включая сайт самого автора спецификации и docs.mistral.ai на платформе Mintlify, этот заголовок не отдаётся – хотя markdown-копии страниц у FastHTML реально существуют и открываются напрямую. Механизм описан в тексте, но развёрнут пока нигде из проверенного мной.
Второе изменение – формально разрешены обе формы адреса markdown-копии страницы: старая (page.html.md, добавление .md к полному пути) и новая (page.md, замена расширения). Первая версия спецификации называла только старый вариант, поэтому сайты, у которых копии лежат по схеме page.md, до августа формально были вне формата.
Третье – работа файла в подпутях получила описанную семантику: если на сайте несколько файлов llms.txt под разными путями, агент должен использовать самый специфичный из подходящих. Так устроен llms.txt у Cloudflare: корневой файл – оглавление, которое ссылается на отдельный llms.txt каждого продукта, а не пытается описать всё сразу одним списком.
Четвёртое – из спецификации убран инструмент llms_txt2ctx, а вместе с ним исчезла и механическая семантика секции Optional: раньше она напрямую указывала инструменту разворачивания контекста, какие ссылки можно выбросить при сборке усечённой версии. Теперь Optional в файле – просто договорённость сообщества о второстепенных ссылках, без встроенного поведения на стороне агентов. Это ровно то удаление, из-за которого у llms-full.txt не осталось даже косвенной опоры в тексте спецификации. Отраслевая пресса зафиксировала релиз в тот же день – Search Engine Journal назвал его первой ревизией формата с момента запуска.
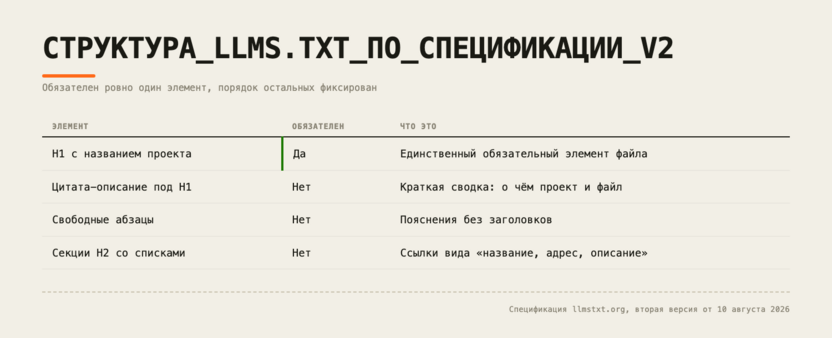
Обязателен ровно один элемент – заголовок первого уровня с названием проекта.
Что в файле обязательно, а что нет
Обязательный элемент ровно один – заголовок первого уровня (H1, строка markdown с одним символом # в начале) с названием проекта. Всё остальное спецификация оставляет необязательным, но задаёт фиксированный порядок, в котором эти части идут, если они есть:
H1с названием проекта – единственный обязательный элемент.- Цитата (
blockquote, строка markdown с символом>в начале) с кратким описанием проекта. Спецификация называет её содержащей ключевую информацию для понимания остального файла. - Ноль или более обычных абзацев без заголовков – свободный текст с деталями, которые не поместились в описание.
- Ноль или более секций второго уровня (
H2, два символа#), каждая – список ссылок вида- название: описание. Двоеточие с описанием после ссылки необязательно.
Заголовков третьего уровня и глубже формат не предусматривает: весь список ссылок живёт внутри H2-секций, вложенность здесь не нужна. Минимальный валидный файл выглядит так:
# Название проекта


> Одно предложение о том, что это за проект и чем он занимается.


## Docs

- [Быстрый старт](https://myproject.dev/docs/quickstart.md): установка и первый запуск

- [Справочник API](https://myproject.dev/docs/api.md): полное описание методов


## Optional

- [Журнал изменений](https://myproject.dev/docs/changelog.md): история версий
Формально цитата с описанием необязательна, но класть её стоит: именно из неё агент понимает, что за проект перед ним, прежде чем пойдёт по ссылкам. Файл без описания – это голый список адресов без объяснения, зачем по ним ходить.
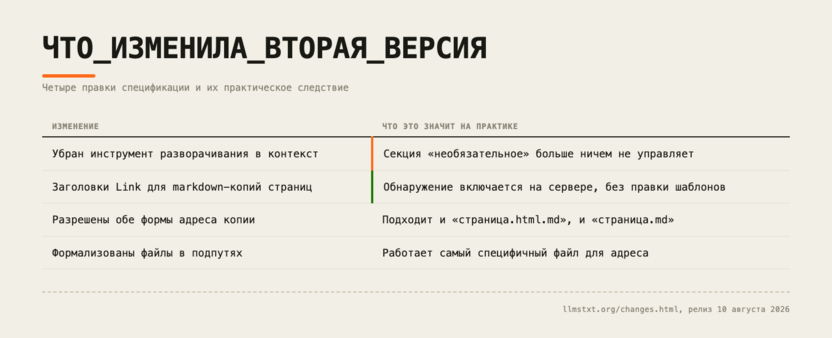
Четыре правки второй версии и то, что каждая из них меняет в работе.
Как собрать такой файл скриптом из карты сайта
Спецификация прямо предлагает собирать файл классическими техниками программирования – парсерами и регулярными выражениями, без машинного обучения; у самого формата есть официальный модуль и консольная утилита на Python. Источник списка страниц проще всего взять из sitemap.xml – служебного XML-файла со списком всех публичных адресов сайта, который отдаёт почти любая система управления сайтом или статический генератор. Скрипт написан на стандартной библиотеке Python 3.7 и старше, ставить ничего не нужно: он читает карту сайта, раскладывает адреса по разделам и собирает из них файл по той же структуре – H1, описание цитатой, H2-секции со списками ссылок.
#!/usr/bin/env python3
"""
make_llms_file.py – сборка llms.txt по спецификации v2 из sitemap.xml.

    python3 make_llms_file.py https://example.dev/sitemap.xml \
        --name "Example Project" \
        --summary "Документация и справочник API Example Project." \
        --out llms.txt
"""

import argparse
import urllib.error
import urllib.request
import xml.etree.ElementTree as ET
from collections import defaultdict
from typing import Dict, List
from urllib.parse import urlparse

NS = "{http://www.sitemaps.org/schemas/sitemap/0.9}"

def fetch_xml(url: str) -> ET.Element:
    req = urllib.request.Request(url, headers={"User-Agent": "llms-file-maker/1.0"})
    try:
        with urllib.request.urlopen(req, timeout=15) as resp:
            return ET.fromstring(resp.read())
    except urllib.error.HTTPError as err:
        raise SystemExit(f"{url}: сервер ответил {err.code}")
    except urllib.error.URLError as err:
        raise SystemExit(f"{url}: не удалось получить файл ({err.reason})")
    except ET.ParseError:
        raise SystemExit(f"{url}: ответ не разобрался как XML – возможно, это HTML-страница")

def load_sitemap_urls(sitemap_url: str, depth: int = 0) -> List[str]:
    root = fetch_xml(sitemap_url)
    tag = root.tag.split("}")[-1]
    if tag == "sitemapindex":
        if depth > 2:
            raise SystemExit("слишком глубокая вложенность карт сайта")
        urls: List[str] = []
        for node in root.iter(f"{NS}sitemap"):
            loc = node.find(f"{NS}loc")
            if loc is not None and loc.text:
                urls.extend(load_sitemap_urls(loc.text.strip(), depth + 1))
        return urls
    return [node.text.strip() for node in root.iter(f"{NS}loc") if node.text]

def group_by_section(urls: List[str]) -> Dict[str, List[str]]:
    sections: Dict[str, List[str]] = defaultdict(list)
    for url in urls:
        path_parts = [p for p in urlparse(url).path.split("/") if p]
        section = path_parts[0].capitalize() if path_parts else "Docs"
        sections[section].append(url)
    return sections

def page_title(url: str) -> str:
    slug = urlparse(url).path.rstrip("/").rsplit("/", 1)[-1] or "index"
    return slug.replace("-", " ").replace("_", " ").capitalize()

def render(name: str, summary: str, sections: Dict[str, List[str]]) -> str:
    lines = [f"# {name}", "", f"> {summary}", ""]
    for section, urls in sorted(sections.items()):
        lines.append(f"## {section}")
        lines.append("")
        for url in sorted(urls):
            lines.append(f"- [{page_title(url)}]({url})")
        lines.append("")
    return "\n".join(lines).rstrip() + "\n"

def main() -> None:
    parser = argparse.ArgumentParser()
    parser.add_argument("sitemap_url")
    parser.add_argument("--name", required=True)
    parser.add_argument("--summary", required=True)
    parser.add_argument("--out", default="llms.txt")
    args = parser.parse_args()

    urls = load_sitemap_urls(args.sitemap_url)
    if not urls:
        raise SystemExit("В карте сайта не нашлось ни одного адреса – проверьте адрес sitemap.xml")

    sections = group_by_section(urls)
    text = render(args.name, args.summary, sections)
    with open(args.out, "w", encoding="utf-8") as f:
        f.write(text)
    print(f"собрано {len(urls)} адресов в {len(sections)} разделов -> {args.out}")

if __name__ == "__main__":
    main()
Пустая строка после каждого ## Раздел в функции render стоит не для красоты: без неё список прилипает к заголовку, и часть парсеров markdown перестаёт считать его списком.
Карта карт обрабатывается отдельной веткой, и это не перестраховка. Если сайт отдаёт sitemap_index.xml (XML-файл, внутри которого лежат адреса других карт, а не страниц), наивный проход по тегам loc соберёт адреса самих карт – и на выходе получится формально валидный файл, где вместо страниц перечислены XML-карты. Молча, без единой ошибки. Поэтому скрипт сначала смотрит на корневой тег: sitemapindex означает, что каждую вложенную карту нужно загрузить отдельно и склеить результаты.
Второе ограничение: группировка по первому сегменту пути даёт черновик, а не готовый к публикации файл. Часть разделов придётся объединить, часть – переименовать по-человечески, а служебные страницы (вход, корзину, технические редиректы) выбросить из списка совсем.
Ещё одно отличие от примера выше: в нём ссылки ведут на markdown-копии страниц (quickstart.md), а скрипт складывает адреса как они лежат в карте сайта – на обычные HTML-страницы. Спецификация допускает и то, и другое; если markdown-копии у вас есть, добавьте к адресу расширение в функции render одной строкой.
Отдельно стоит закрыть момент, на котором споткнулся Сбер: готовый файл нужно раздавать с явным Content-Type: text/plain (или text/markdown, если он написан как полноценный markdown-документ), а не полагаться на то, что сервер сам угадает тип по расширению .txt. Если файл лежит в той же зоне маршрутизации, что и остальной сайт, и на неизвестный путь настроен catch-all-обработчик (перехватывающий все нераспознанные адреса), результат – ровно тот HTML вместо текста, который я нашёл на developers.sber.ru.
Как проверить свой файл: пять команд
Тот же набор команд, которым я проверял чужие файлы, годится и для своего – и повторять его стоит при любом переезде документации, а не один раз при заведении файла.
Первое – заголовки. curl -sI на адрес файла показывает код статуса и Content-Type; статус должен быть 200, а тип – text/plain или text/markdown, а не text/html. Это ловит паттерн Сбера, где вместо файла отвечает страница ошибки.
Второе – если на сайте есть и llms.txt, и второй файл под любым другим именем, сравнить их содержимое побайтово:
curl -s https://example.dev/llms.txt | md5sum

curl -s https://example.dev/llms-full.txt | md5sum
Совпавшие отпечатки означают, что второй файл – не расширенная версия, а копия под другим именем. Это ловит паттерн, который я нашёл у Expo и ElevenLabs в начале сентября. На macOS утилита называется md5, а не md5sum; остальная часть строки не меняется.
Третье – проверить, не ведёт ли адрес на HTML-страницу вместо текста после редиректа. У curl -sI для этого есть флаг -L, который проходит всю цепочку переадресаций и показывает финальный код и заголовки. Это ловит паттерн Cursor и старого адреса Anthropic.
Четвёртое – прогнать файл через открытый валидатор @bridgetoagent-com/llms-txt-validator (свободная лицензия MIT, ставится из репозитория пакетов npm, работает из командной строки и умеет отдавать результат в формате JSON через режим --json – так проверку встраивают в автоматическую сборку проекта). Он находит семь типов дефектов:
H1не первым непустым блоком в файле;- заголовки уровня
H3и глубже, не предусмотренные форматом; - пункты списка не по шаблону
- текст; - пустой текст ссылки или пустой адрес;
- ссылки на
http://вместоhttps://– агенты, отказывающиеся ходить по незащищённым ссылкам, такую ссылку просто пропускают; - повторяющиеся адреса и повторяющийся текст ссылок;
- медленные ссылки, дольше трёх секунд ответа, – при включённой опции
--check-links.
Пятое – заголовок Link из второй версии спецификации: curl -sI по адресу обычной HTML-страницы сайта и поиск строки link: в ответе. Ни один из проверенных мной десяти доменов его не отдаёт, но проверить у себя стоит: это один из немногих способов объявить о markdown-копии страницы, не трогая саму страницу.
Читают ли эти файлы боты
Данные говорят, что почти нет. Ahrefs 15 июня 2026 года опубликовал разбор логов и трафика 137 000 доменов. - llms.txt публикуют 28% доменов выборки, с валидным файлом – около 38 000;
- 97% этих файлов за период наблюдения не получили ни одного запроса вообще;
- у оставшихся 3% 96% запросов пришло от ботов, и 77% этих ботов не связаны с ИИ-инструментами;
- на боты, которые забирают содержимое для поиска или ответа модели и связаны с ChatGPT и Perplexity, пришлось около 19,5% запросов – но это доля внутри узкой выборки файлов с трафиком, а не от всех 137 000 доменов.
Отдельно Ahrefs отметил: ни один ИИ-бот не пытался запросить llms.txt на доменах, где файла вообще не было.
OtterlyAI провёл 90-дневный эксперимент на тестовом домене: из 62 100 с лишним визитов ИИ-ботов на сайт на /llms.txt пришлось только 84 запроса, около 0,1% всего ботового трафика, тогда как средняя страница того же сайта получала около 265 визитов ИИ-ботов за тот же период – то есть llms.txt получал примерно втрое меньше внимания ботов, чем обычная страница. По итогам эксперимента OtterlyAI убрал llms.txt из своего чек-листа аудита видимости в ИИ-поиске.
При этом статус файла остаётся раздвоенным. Google 5 мая 2026 года добавил проверку наличия llms.txt в Chrome Lighthouse (инструмент аудита сайта, встроенный в браузер), в новую категорию Agentic Browsing audits – то же зафиксировал Search Engine Land. Формулировка Google: аудит проверяет наличие машиночитаемой сводки в корне домена как сигнал для агентного просмотра, а не как директиву для краулинга. При этом собственное руководство Google по оптимизации под генеративный поиск относит llms.txt к файлам, не нужным для показа в Google Search, AI Overviews и AI Mode – то есть для ранжирования Google Search его игнорирует. Прямую страницу руководства мне открыть не удалось, факт я беру по трём независимым пересказам с цитатами: Scalevise, Webyes и Search Engine Journal.
Ни один крупный поставщик моделей – ни OpenAI, ни Anthropic, ни Google, ни Perplexity, ни Meta, ни Mistral – публично не подтвердил, что его продуктовый ассистент использует содержимое llms.txt в момент ответа на запрос пользователя. GPTBot, краулер обучения OpenAI, встречается в логах чаще других при обращении к файлу, но это фиксирует лишь факт скачивания, а не то, что содержимое попадает в ответ.
Что я делаю у себя
Я держу файл, но не строю вокруг него стратегию – цифры Ahrefs и OtterlyAI для этого слишком однозначные. Сборка скриптом и прогон через валидатор занимают около десяти минут, и это разумная цена даже при вероятности, что файл никто не прочитает. Дороже стоит не завести файл, а забыть про него после следующего переезда документации: ровно так на моей табличке оказались Cursor и старый адрес Anthropic. Поэтому пять проверок – статус, тип содержимого, сравнение с соседним файлом, полная цепочка редиректов, валидатор – я прогоняю не один раз при публикации, а при каждой миграции документации, тем же способом, каким проверял чужие файлы для этой статьи.
Комментарии