

Меня зовут Сергей Язовский. 15 лет занимаюсь поисковым продвижением, последние три года – в основном GEO-оптимизацией, то есть попаданием сайтов в ответы нейросетей.
В конце прошлого года меня позвал поговорить директор завода, который выпускает промышленные насосы. Сайт живой: каталог на 400 позиций, техдокументация, чертежи в PDF, заявки приходят стабильно. Разговор вышел странный. За последние месяцы к нему трижды приезжали покупатели со словами «мне вас нейросеть посоветовала». Он удивился, открыл Алису и спросил, кто в России делает такие насосы. Услышал четыре компании. Своего завода в списке не нашёл. Спросил у ChatGPT – получил другие три названия и снова не себя.
Дальше обсуждали уже не нейросети, а деньги. Если клиент приходит за советом к модели и тебя в этом совете нет, ты не проигрываешь тендер. Ты на него не попадаешь. Разница принципиальная, и она плохо считывается через привычную воронку.
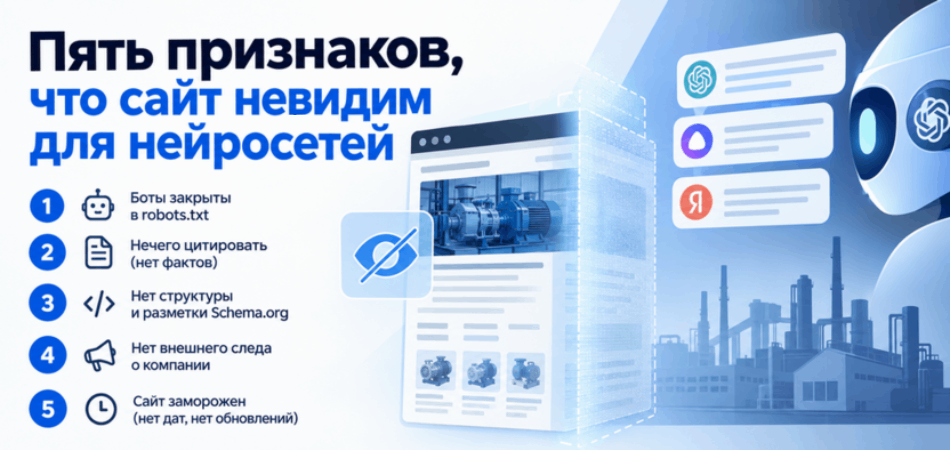
Короткий ответ на вопрос из заголовка выглядит так. Сайт невидим для нейросетей, когда:
- Боты нейросетей закрыты в robots.txt, причём часто по незнанию.
- Из текста страницы нельзя вытащить ни одного факта – только обещания.
- Страница не разобрана на блоки, а разметки Schema.org на ней нет вообще.
- О компании пишут только на её собственном сайте.
- Сайт заморожен: нет дат, материалы не обновлялись годами, а половина содержимого подгружается скриптами.
Пять пунктов, каждый проверяется за вечер. Ниже разбираю по порядку, что происходит и что с этим делать.
Почему это вообще стало проблемой
Цифры за 2025 год, которые стоит держать в голове, потому что спорить с ними бесполезно.
Исходящий трафик из нейросетей на российские сайты за год вырос более чем в 9 раз. Это оценка Digital Budget, которую цитировал «Коммерсантъ». Абсолютная величина пока скромная на фоне обычного поиска, но скорость роста важнее объёма.
ВЦИОМ в сентябре 2025 года выяснил, что 51% интернет-пользователей в России уже пользуются нейросетями, и 63% из них задают им вопросы именно для поиска информации. То есть больше половины взрослой аудитории страны воспринимает языковую модель как справочное бюро.
И ещё одна цифра, которая объясняет, почему нельзя просто «засветиться один раз». По исследованию FAVES Communications, 34% россиян никогда не переходят на источник после ответа ИИ. Модель назвала компанию – и этого достаточно. Никакого клика по ссылке не будет, посещаемость не покажет, что сделка пришла из чата.
Отсюда простое следствие: если вас нет в ответе, вы не существуете для этой части покупателей. Ни в отчётах аналитики, ни в разговоре с отделом продаж.
Признак 1. Боты нейросетей закрыты в robots.txt
Самая быстрая проверка из всех и самая частая причина невидимости. Открываю файл robots.txt на сайте, который пришли смотреть, и регулярно вижу строки вида:
User-agent: GPTBot
Disallow: /

User-agent: Google-Extended
Disallow: /

User-agent: CCBot
Disallow: /
Выглядит как забота о своём контенте. На практике часто это результат чужого совета двухлетней давности, когда все массово закрывали обучающие краулеры, чтобы тексты не уходили в датасеты. Затея сомнительная сама по себе, но беда в другом: вместе с обучающими ботами многие закрыли поисковых и живых агентов.
Давайте разберёмся, кто вообще ходит по сайту, потому что это три разных типа, и путать их нельзя.
Обучающие краулеры (GPTBot, Google-Extended, CCBot) собирают данные для тренировки моделей. Их закрывать можно. Хотите не отдавать тексты в обучение – ваше право, и на попадание в ответы это прямо не влияет.
Поисковые краулеры (OAI-SearchBot, PerplexityBot, Bingbot, YandexBot) строят индекс, из которого модель берёт источники. Закрыть их – значит вычеркнуть себя из ответов.
Живые агенты (ChatGPT-User, Claude-User) заходят на страницу в момент запроса пользователя, чтобы прочитать её здесь и сейчас. Закрыть их – значит оборвать разговор ровно в тот момент, когда вас выбрали.
Отдельно про Яндекс. Есть малоизвестная строка, о которой знают единицы, а работает она как выключатель. Директива YandexAdditional (и связанный с ней YandexAdditionalBot) по документации Яндекса учитывается при ограничении показа содержимого страницы в быстрых ответах на основе YandexGPT и в ответах Поиска с Алисой. Это не краулер. Это переключатель «показывать эту страницу в нейроответах или нет». Если в чужом шаблоне robots.txt прилетела строка с этим именем и Disallow, страница исчезает из ответов Алисы, даже когда она честно ранжируется в обычной выдаче.
Ещё про механику Алисы, чтобы понимать, откуда она берёт данные. YandexGPT опирается на индекс Яндекса. Практическое правило, которое я вывел по своим наблюдениям: страница должна попадать хотя бы в первые 30 позиций обычного поиска по своему запросу. Ниже – нейроответ её скорее всего не подхватит, потому что до этого блока выдача просто не доходит. ChatGPT с поиском исторически опирается на индекс Bing и собственный обход, поэтому локальные российские запросы вроде «кто производит такие насосы в Перми» он закрывает заметно слабее.
Как проверить. Открываете ваш-сайт.рф/robots.txt, ищете по списку имена ботов. Если напротив OAI-SearchBot, PerplexityBot или YandexBot стоит Disallow со слэшем – проблема найдена. Тут же смотрите, нет ли строки YandexAdditional.
Что делать. Привести файл к состоянию, когда поисковые и живые агенты допущены, а обучающие отсечены, если вы так решили:
User-agent: GPTBot
Disallow: /

User-agent: Google-Extended
Disallow: /

User-agent: CCBot
Disallow: /

User-agent: OAI-SearchBot
Allow: /

User-agent: ChatGPT-User
Allow: /

User-agent: PerplexityBot
Allow: /

User-agent: ClaudeBot
Allow: /

User-agent: YandexBot
Allow: /
Строку с YandexAdditional убираете совсем, чтобы не сработала по умолчанию. И не поленитесь проверить дату последнего запуска ботов в логах сервера – иногда файл открыт, а краулеров всё равно не видно, потому что их режет защита хостинга от нагрузки. Такое я встречал на трёх проектах из десяти: робот получает 403 и перестаёт возвращаться.
Признак 2. Контенту нечего процитировать
Открываю страницу «О компании» на сайте машиностроительного предприятия. Читаю: «Мы молодая динамично развивающаяся команда профессионалов. Индивидуальный подход к каждому клиенту. Гибкая ценовая политика. Мы гордимся своей репутацией надёжного партнёра».
Пятнадцать лет в профессии, и я до сих пор не понимаю, как из этого текста покупатель должен что-то понять. С нейросетью хуже вдвойне. Она не может вытащить из абзаца ни одного утверждения, которое можно вставить в ответ. Модель не пересказывает настроение, она пересказывает факты.
Сравните два варианта на одном и том же производстве.
Было: «Мы производим качественное оборудование для нефтегазовой отрасли».
Стало: «Выпускаем 120 единиц насосного оборудования в месяц на площадке в 6 400 квадратных метров. Срок изготовления серийной позиции – 45 рабочих дней, нестандартной – от 90. Гарантия 24 месяца. Работаем с 2011 года, 38 единиц оборудования стоят на объектах в Западной Сибири и Ямало-Ненецком округе».
Второй абзац нейросеть может процитировать почти дословно, и он останется правдивым. Причём это работает и для человека: покупатель звонит туда, где указана мощность производства, потому что понимает, влезет ли его заказ в план.
Про доказательную базу есть исследование GEO-Bench от команды Princeton. Оно показало, что добавление в текст конкретной статистики напрямую повышает видимость страницы в ответах генеративных систем. Не оптимизированная плотность ключевых слов, а цифры.
Как проверить. Возьмите свою страницу и попробуйте выписать из неё пять утверждений, каждое из которых можно проверить. Срок изготовления, объём выпуска, площадь цеха, гарантийный срок, год открытия, количество сотрудников, наличие собственного конструкторского отдела, парк станков. Если получилось меньше трёх – цитировать нечего.
Что делать. Пройти по десяти ключевым страницам и вписать в них числовые характеристики. Проще говоря, дать модели строительный материал. Пусть каждая страница содержит хотя бы один абзац, который можно вырвать из контекста без потерь.
Признак 3. Страница не разобрана на блоки и не размечена
Классическая картина: страница на 15 тысяч знаков, состоящая из трёх абзацев размером с экран каждый. Ни подзаголовков, ни списков, ни таблиц. Инженеру читать неудобно, а краулеру просто не за что зацепиться: нет структуры, которая объясняет, где здесь вопрос, а где ответ.
Второй слой той же проблемы – отсутствие микроразметки Schema.org. Это способ объяснить машине, что именно лежит на странице. Article – это статья, Organization – это компания, Product – это продукция, HowTo – инструкция, FAQPage – блок вопросов и ответов. Разметка видна в исходном коде и в панелях для вебмастеров, её легко поставить и легко проверить.
Почему это критично именно для нейросетей. По данным исследования Ahrefs, сайты с полной микроразметкой упоминаются в генеративных ответах примерно в 2,7 раза чаще, чем страницы без неё. Разница внушительная, и объяснение у неё простое: модели проще достать готовую пару «вопрос – ответ», чем вырезать её из простыни текста.
Отдельно скажу про то, что обычно советуют. Многие консультанты предлагают сразу поставить максимальное количество типов разметки на все страницы подряд. На практике это даёт мусор: если на карточке детали стоит разметка FAQPage с вопросами, которых никто не задавал, а рядом вписана разметка Article, поисковики и модели видят противоречивые сигналы и просто отбрасывают разметку целиком. Работает не количество, а совпадение типа разметки с реальным содержимым страницы.
Как проверить. Возьмите одну страницу каталога. Посмотрите на неё на телефоне и спросите себя, можно ли прочитать её по заголовкам, не теряя смысл. Потом откройте страницу как код (Ctrl+U) и поищите там слово schema. Если не нашли – разметки нет.
Что делать. Начать с малого: FAQPage на страницах с частыми вопросами покупателей, Organization на главной и в контактах, Product на карточках продукции. Разметку ставят руками или плагином, специалист справляется за пару часов.
Признак 4. О компании пишут только на её собственном сайте
Самый недооценённый пункт из пяти. Нейросеть собирает образ компании не из одного источника, а из множества. И если весь цифровой след предприятия состоит из его же сайта и карточки в справочнике, для модели эта компания не подтверждена.
Аналогия простая. Когда вы спрашиваете знакомого, к какому врачу пойти, вы доверяете рекомендации, за которой стоят реальные истории. Если человек советует специалиста, о котором сам узнал из его же визитки, совет ничего не стоит. С моделью ровно так же: одному источнику она верит слабо, а совпадению данных из разных мест – сильно.
Что считается внешним следом для производственного предприятия: публикации в отраслевых изданиях, карточки в профильных каталогах и реестрах, отзывы на независимых площадках, материалы с отраслевых выставок и конференций, упоминания в региональных новостях о запуске новых линий или освоении новых изделий. Полезно и то, что лежит на сайтах партнёров и крупных заказчиков: совместные проекты, поставки, участия в тендерах.
Как проверить. Откройте Алису и задайте вопрос, который задал бы ваш покупатель: «кто в России делает такие-то насосы» или «производитель такого-то оборудования». Посмотрите, какие названия она перечислит. Потом повторите то же самое в ChatGPT. Списки разойдутся, и это нормально: ChatGPT опирается на Bing и свои данные, поэтому по российским регионам он отвечает слабее, зато по международным рынкам точнее.
Что делать. Составить список из 10-15 площадок, где ваша компания должна упоминаться, и постепенно их заполнять. Отраслевые каталоги, профильные медиа, реестры производителей, отзывы реальных заказчиков. Год работы по этому направлению даёт заметный сдвиг, месяц – нет.
Признак 5. Сайт заморожен
Последняя новость на сайте датирована 2019 годом. В каталоге указаны цены, которые уже неактуальны. Даты публикации у страниц нет вообще, только год в футере с копирайтом, который тоже не обновлялся.
Для модели это сигнал живого заброшенного объекта. Краулер приходит, видит, что ничего не менялось, и снижает частоту обходов. А при выборе источника для ответа свежесть учитывается напрямую: между двумя похожими страницами модель чаще возьмёт ту, где есть актуальная дата и видимые обновления.
Второй слой проблемы – рендеринг. Часть сайтов собирает содержимое скриптами: в исходном HTML пустой каркас, а текст появляется после выполнения JavaScript. Мощные поисковые системы это дотягивают, но не все боты одинаково хорошо справляются, а живые агенты вроде ChatGPT-User приходят на страницу в момент запроса и читают то, что успели получить. Если это пустой каркас, цитировать им нечего.
Как проверить. Отключите JavaScript в браузере и посмотрите на страницу каталога. Если вместо текста и характеристик пустота – вопрос найден. Заодно посмотрите, есть ли в карточках дата обновления и указан ли год в характеристиках.
Что делать. Вернуть даты публикации и обновления. Плановый пересмотр каталога раз в квартал – не формальность, а способ показать, что объект живой. Если на сайте есть раздел новостей или технических статей, он должен пополняться хотя бы раз в месяц: производственному предприятию всегда есть что сказать – новая линия, новый станок, участие в выставке, освоенная позиция.
Сводная таблица: признак, проверка, тревожный сигнал
| Признак | Как проверить | Тревожный сигнал |
|---|---|---|
| Боты закрыты | Открыть robots.txt, найти имена ботов | Напротив OAI-SearchBot, PerplexityBot или YandexBot стоит Disallow: / |
| Нечего цитировать | Выписать пять проверяемых фактов со страницы | Фактов меньше трёх, только слова про качество и надёжность |
| Нет структуры и разметки | Посмотреть страницу в коде, поиск по слову schema | Подзаголовков и таблиц нет, слово schema не найдено |
| Нет внешнего следа | Спросить Алису и ChatGPT о своей отрасли | Компании нет ни в одном из двух ответов |
| Сайт заморожен | Отключить JavaScript, посмотреть даты | Страница пустая, даты публикации и обновления отсутствуют |
Пять строк. Если у вас больше трёх тревожных сигналов, положение тяжелее, чем кажется, но и отдача от исправлений будет быстрее.
С чего начать на этой неделе
Порядок работ имеет значение, и он не совпадает с тем, как обычно советуют. Почти все начинают с текстов: переписывают страницы, добавляют факты, правят заголовки. Смысла в этом мало, если боты закрыты: вы улучшите контент, который никто не прочитает.
Мой порядок такой.
Сначала техническая доступность. День работы, никаких подрядчиков не нужно. Открыть поисковым и живым ботам вход, убрать строку с YandexAdditional, проверить логи сервера на 403 для краулеров. Это фундамент, без него остальное не работает.
Потом факты и разметка. Две-три недели, если идти постепенно. Начать с десяти самых посещаемых страниц: добавить числовые характеристики, разбить текст на блоки, поставить FAQPage и Product там, где они уместны.
И только в конце – внешний след. Самый долгий этап, от нескольких месяцев. Отраслевые каталоги, публикации, отзывы заказчиков, материалы с выставок.
Часто задаваемые вопросы
Можно ли попасть в ответы нейросетей, если у компании вообще нет сайта?
Можно, но у вас останется один инструмент из четырёх. Модель сможет опираться на внешние упоминания: каталоги, отраслевые публикации, отзывы, данные из карт и справочников. Так иногда получается – например, если вы много лет поставляете продукцию известным заказчикам и это где-то зафиксировано. Но управлять этим вы почти не сможете, а каждая неточность в чужом источнике уйдёт в ответ как факт.
Сколько времени ждать первых результатов?
Разделю на две части. Техническая доступность и разметка дают эффект после переобхода – это недели, иногда пара месяцев, в зависимости от того, как часто краулеры заходят на ваш сайт. Внешний след работает медленнее: первые изменения в ответах я обычно вижу через три-четыре месяца после начала работы с публикациями и каталогами. Обещать «через две недели будете в топе ответов» не стану, это неправда.
Надо ли переделывать весь сайт целиком?
Нет. Практика показывает, что достаточно двадцати-тридцати страниц, если это правильные страницы: каталог, ключевые карточки продукции, раздел о производстве, контакты. Сайт на 500 страниц с разметкой только на главной будет цитироваться хуже, чем аккуратный сайт на 40 страниц с полным порядком.
Влияет ли реклама на упоминание в ответах нейросетей?
Прямо – нет. Модель не различает, купили вы показы или нет. Косвенно – да, и заметно: рекламные материалы часто попадают в отраслевые медиа, каталоги и обзоры, а вот они уже становятся источниками для модели. Плюс рекламный трафик сам по себе не создаёт цитируемых фактов, поэтому оплаченные переходы без нормального контента ничего не изменят.
Есть ли смысл небольшому предприятию этим заниматься?
Смысл есть, и часто именно небольшим проще. Крупный производитель уже упоминается в десятках источников, ему сложнее менять свой образ в ответах модели. Небольшому заводу достаточно десяти-пятнадцати корректных внешних упоминаний и честных цифр на сайте, чтобы начать появляться в ответах по узким запросам. А узкие запросы в промышленности и есть самые денежные.
Не навредит ли оптимизация сайта под нейросети обычному поиску?
Не должна, если делать по-человечески. Все пять признаков из этой статьи – это либо техническая гигиена, либо качественный контент, либо внешние упоминания. Ровно то же самое улучшает позиции в обычном поиске. Вред начинается там, где под нейросети пытаются набивать текст ключевыми словами в расчёте на то, что модель проглотит. Она не глотает, а поиск за такое снимает позиции.
Как часто проверять результат?
Раз в месяц, не чаще. Задавайте Алисе и ChatGPT 10-15 живых вопросов своих покупателей и записывайте, упомянули вас или нет. Раз в квартал имеет смысл смотреть динамику: появилось ли ваше имя в ответах там, где раньше не было. Ежедневные проверки бессмысленны: переобход индекса идёт не по вашему расписанию, а волатильность ответов моделей высокая.
Если признаки нашлись
Пять признаков – это диагностика, а не приговор. Каждый из них лечится, и ни один не требует смены платформы, перезапуска сайта или крупных бюджетов.
Единственное, на чём настаиваю: начинайте не с текстов, а с технической доступности. Мне регулярно приносят сайты, где переписаны все страницы, добавлены характеристики и разметка, а в robots.txt спокойно стоит запрет для поискового бота. Люди полгода работали над контентом, который ни одна модель не имеет права прочитать. Обидно, и исправляется это одной строкой.
Если хотите понять, работает ли GEO у вас – заходите на geouseo.ru. Я бесплатно проверю: упоминают ли вас ChatGPT, Gemini или Яндекс GPT по 5 ключевым запросам вашей целевой аудитории. Без шаблонных отчётов – просто скажу, где вы есть, а где вас нет, и что с этим делать.

Комментарии