

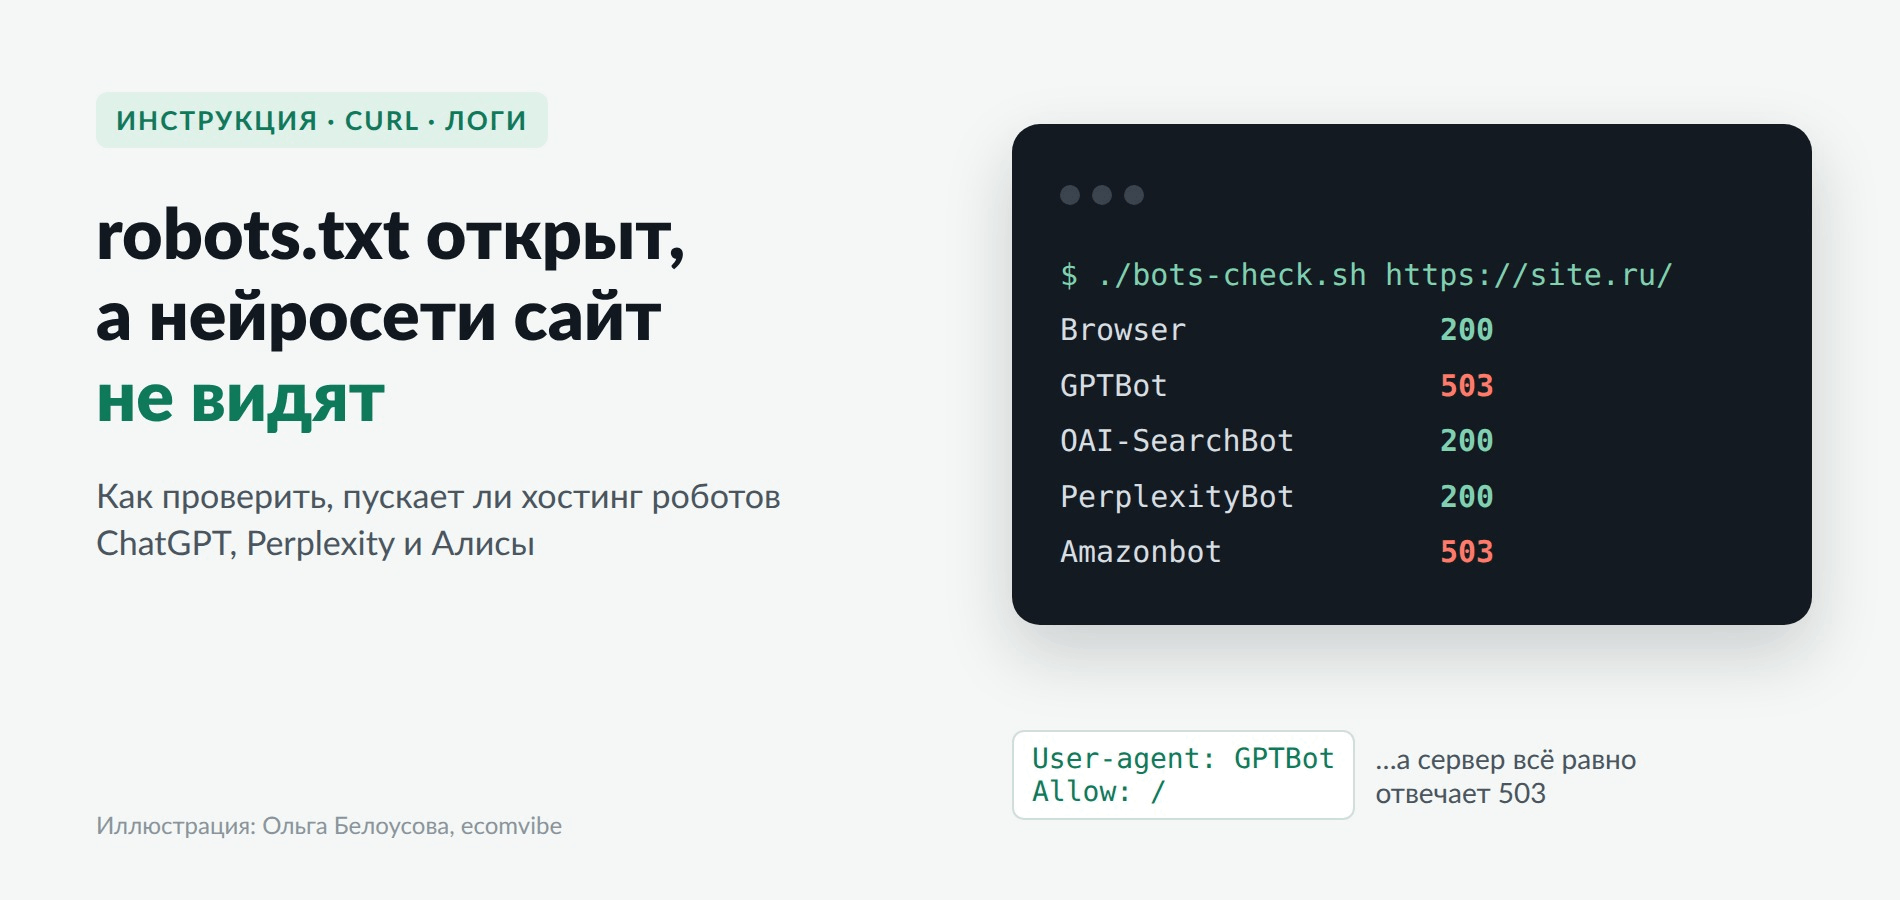
Пошаговая проверка с curl, логами и списками IP-адресов: что делать, если поисковый робот ChatGPT, Perplexity или Алисы получает 503 вместо страницы, хотя в robots.txt всё разрешено.
Откуда взялась проблема
В октябре я проверяла, как роботы нейросетей видят сайт нашей студии. robots.txt был открыт для всех: GPTBot, OAI-SearchBot, ClaudeBot, PerplexityBot, YandexAdditional и десяток других, у каждого отдельная строка Allow. По всем учебникам этого достаточно.
Потом я запросила те же страницы с подписями роботов. Браузеру сервер отдавал 200, а запросу с подписью GPTBot – 503 «Сервис недоступен». Причём не везде: главная, sitemap.xml и проверенные статьи блога – 503, а /blog без слеша в конце – 200. Запросу с подписью Amazonbot сервер отказывал на всех адресах. В тот же день GPTBot получал 503 даже на сам robots.txt.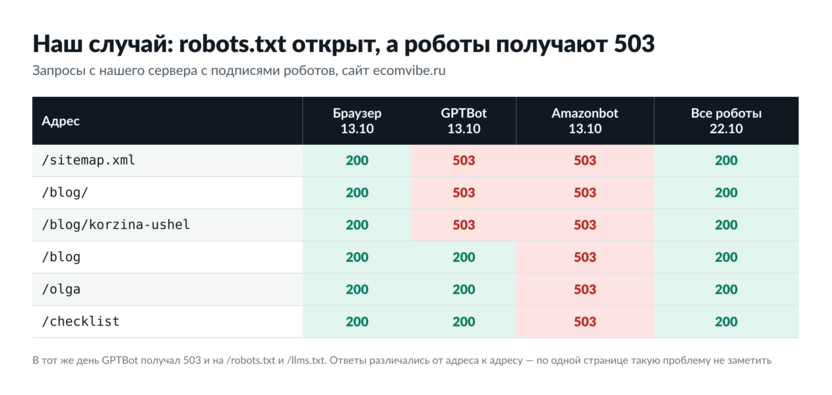
Источник: замеры автора на сайте ecomvibe.ru 13 и 22 октября 2026 года. Таблица – Ольга Белоусова, ecomvibe
Ни одна стандартная проверка этого не показывала. Сайт открывается, Вебмастер ошибок не видит, robots.txt правильный. А роботы, которые собирают ответы нейросетей, часть страниц не получают.
Через девять дней та же проверка показала 200 для всех роботов на всех адресах. Но за это время я поняла главное: robots.txt – не единственное место, где решается, пустят ли робота на сайт. Ниже – как проверить свой сайт за полчаса и что делать, если нашлась проблема.
Почему открытого robots.txt недостаточно
robots.txt – это просьба к роботу, которую он читает сам и сам решает, выполнять ли её. Но до robots.txt запрос проходит через несколько слоёв, и каждый может отказать раньше:
- CDN и WAF. Cloudflare и похожие сервисы умеют блокировать ИИ-ботов одной настройкой и показывать проверку «вы не робот». Робот такую проверку не пройдёт.
- Защита на стороне хостинга. Антибот, лимиты запросов, защита от DDoS. Часто включена по умолчанию, и владелец сайта о ней не знает.
- Сервер и CMS. Правила в .htaccess или конфигурации nginx, плагины безопасности, которые блокируют «подозрительные» подписи. Иногда такие правила добавил прошлый подрядчик, когда боролся с нагрузкой.
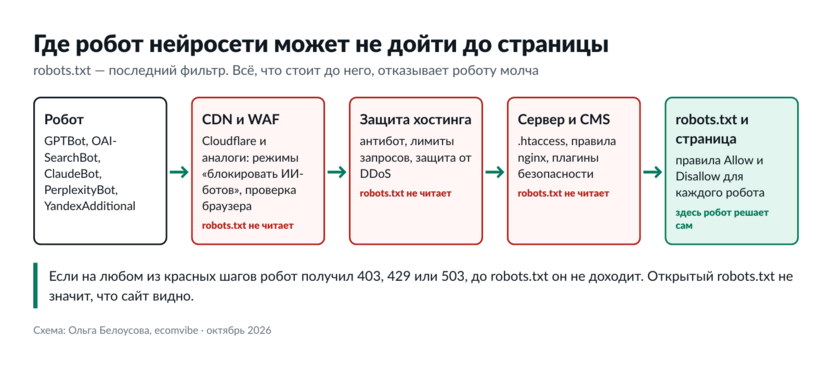
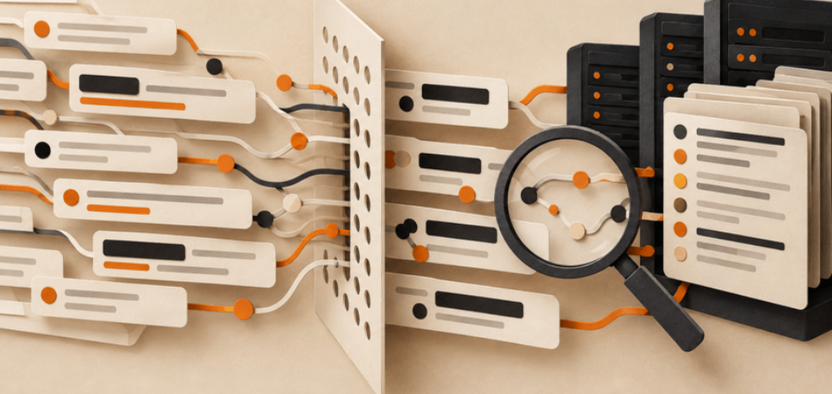
Источник: схема автора – Ольга Белоусова, ecomvibe
Ни один из этих слоёв не читает robots.txt. Если на любом из них робот получил 403, 429 или 503, он уходит ни с чем. В Вебмастере такая проблема не видна: робот Яндекса может проходить нормально, а роботы OpenAI или Anthropic – нет.
Каких роботов проверять
Сначала договоримся, кого вообще ждать на сайте. У каждой крупной компании несколько роботов с разными задачами, и их можно разрешать и запрещать по отдельности.
|
Робот |
Компания |
Зачем приходит |
|
OAI-SearchBot |
OpenAI |
Показывает сайты в поиске ChatGPT |
|
GPTBot |
OpenAI |
Собирает тексты, которые могут использоваться для обучения моделей |
|
ChatGPT-User |
OpenAI |
Открывает страницу, когда пользователь просит ChatGPT её прочитать |
|
Claude-SearchBot |
Anthropic |
Индексирует страницы для ответов Claude с поиском |
|
ClaudeBot |
Anthropic |
Собирает тексты для обучения моделей |
|
Claude-User |
Anthropic |
Открывает страницу по запросу пользователя Claude |
|
PerplexityBot |
Perplexity |
Показывает сайты в результатах Perplexity |
|
Perplexity-User |
Perplexity |
Открывает страницу по запросу пользователя |
|
YandexAdditional |
Яндекс |
Отвечает за быстрые ответы и ответы Алисы AI |
|
YandexBot, Googlebot, Bingbot |
Яндекс, Google, Microsoft |
Обычная индексация для поиска |
Здесь важно разделение. Роботы для поиска (OAI-SearchBot, Claude-SearchBot, PerplexityBot, YandexAdditional) решают, появится ли ваш сайт в ответах нейросетей. Роботы для обучения (GPTBot, ClaudeBot) решают, попадут ли ваши тексты в обучающие данные. Можно разрешить первых и запретить вторых – это нормальное решение, если не хотите отдавать тексты для обучения, но хотите, чтобы на вас ссылались.
Ещё одна деталь: Google-Extended – это не отдельный робот, а метка для robots.txt. Запросов с такой подписью в логах не будет, проверять нечего.
Роботы, которые приходят по запросу пользователя (ChatGPT-User, Perplexity-User), по документации OpenAI и Perplexity могут не следовать robots.txt – ведь страницу попросил открыть человек. Защита хостинга их при этом блокирует так же, как остальных.
Шаг 1. Проверьте, что robots.txt вообще отдаётся
Звучит странно, но начинать нужно с самого robots.txt. Если на запрос к нему робот получает ошибку, он не знает правил сайта и ведёт себя осторожно.
Выполните в терминале:
curl -I https://ваш-сайт.ru/robots.txt
Нормальный ответ – HTTP/2 200 и content-type: text/plain. Перенаправление на главную страницу или на HTML-страницу с ошибкой – это проблема, даже если в браузере robots.txt открывается.
Потом запросите тот же файл с подписью робота:
curl -I -A "Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko); compatible; GPTBot/1.4; +https://openai.com/gptbot" https://ваш-сайт.ru/robots.txt
Ключ -A подставляет подпись (User-Agent), с которой приходит робот. Если ответ отличается от предыдущего – вы нашли первый слой защиты.
Для Яндекса есть отдельный инструмент: Вебмастер → Инструменты → «Анализ robots.txt». Он покажет, как робот Яндекса понял ваши правила, но про роботов других компаний ничего не скажет.
Шаг 2. Запросите страницы от имени разных роботов
Одного адреса мало: в нашем случае ответ менялся от страницы к странице. Возьмите пять-шесть адресов разного типа:
- главную;
- /robots.txt, /sitemap.xml и /llms.txt, если он есть;
- раздел каталога или блога;
- одну карточку товара или статью.
Чтобы не набирать команды вручную, сохраните скрипт в файл bots-check.sh:
#!/usr/bin/env bash
# Проверка: отдаёт ли сайт страницу роботам нейросетей так же, как браузеру
# Запуск: ./bots-check.sh https://example.ru/stranica
URL="$1"
declare -A BOTS=(
  [Browser]="Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/130.0 Safari/537.36"
  [GPTBot]="Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko); compatible; GPTBot/1.4; +https://openai.com/gptbot"
  [OAI-SearchBot]="Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko); compatible; OAI-SearchBot/1.4; +https://openai.com/searchbot"
  [ChatGPT-User]="Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko); compatible; ChatGPT-User/1.0; +https://openai.com/bot"
  [ClaudeBot]="Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko; compatible; ClaudeBot/1.0; +claudebot@anthropic.com)"
  [PerplexityBot]="Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko; compatible; PerplexityBot/1.0; +https://perplexity.ai/perplexitybot)"
  [YandexAdditional]="Mozilla/5.0 (compatible; YandexAdditional/3.0; +http://yandex.com/bots)"
  [Amazonbot]="Mozilla/5.0 (compatible; Amazonbot/0.1; +https://developer.amazon.com/support/amazonbot)"
)
for NAME in Browser GPTBot OAI-SearchBot ChatGPT-User ClaudeBot PerplexityBot YandexAdditional Amazonbot; do
  RES=$(curl -s -o /dev/null -w "%{http_code}   %{size_download}" -A "${BOTS[$NAME]}" "$URL")
  printf "%-18s %s байт\n" "$NAME" "$RES"
done
Сделайте файл исполняемым и запустите:
chmod +x bots-check.sh
./bots-check.sh https://ваш-сайт.ru/
Скрипт выводит код ответа и размер полученной страницы для браузера и для каждого робота. Версии в подписях роботов со временем меняются, актуальные строки публикуют сами компании в документации.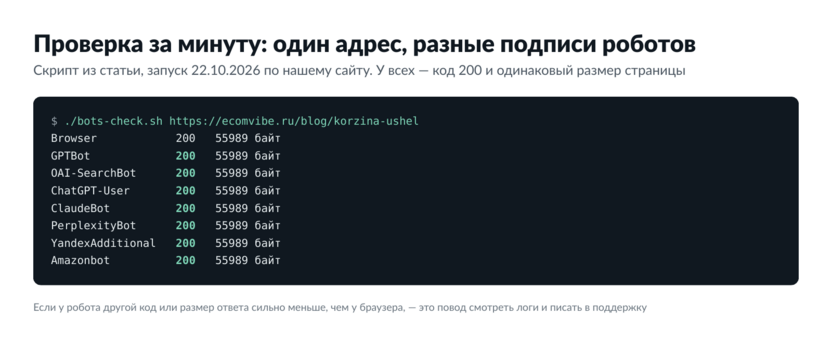
Источник: иллюстрация автора по результатам запуска скрипта bots-check.sh на ecomvibe.ru 22 октября 2026 года
Так выглядит здоровый результат: у всех один код и одинаковый размер. Размер важен не меньше кода. Если браузер получил 56 000 байт, а робот – 3 000 при коде 200, скорее всего, роботу показали проверку «вы не робот» или заглушку. Откройте такой ответ и посмотрите, что внутри:
curl -s -A "…подпись GPTBot…" https://ваш-сайт.ru/ | head -50
Шаг 3. Расшифруйте ответы
Сравнивайте каждый ответ роботу с ответом браузеру на тот же адрес в ту же минуту.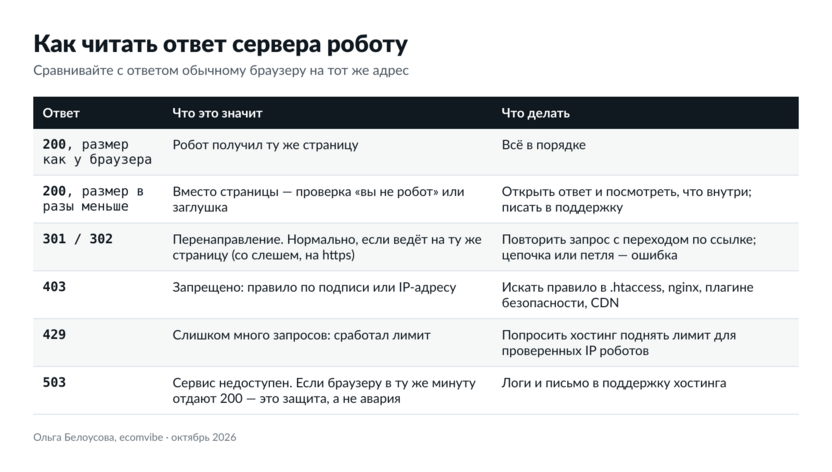
Источник: таблица автора – Ольга Белоусова, ecomvibe
Шаг 4. Сверьтесь с логами: подпись – это ещё не робот
У проверки через curl есть ограничение, о котором часто забывают. Вы подставляете подпись робота, но запрос идёт с вашего компьютера, а не с серверов OpenAI. Хорошая защита проверяет не только подпись, но и IP-адрес – и вправе отказать подделке, пропустив настоящего робота.
Поэтому результат шага 2 – это повод для проверки, а не приговор. Окончательный ответ дают журналы доступа (access log). На виртуальном хостинге они обычно есть в панели управления, на своём сервере – в /var/log/nginx/ или /var/log/apache2/.
Посмотреть, какие ответы получали роботы нейросетей:
grep -E "GPTBot|OAI-SearchBot|ClaudeBot|Claude-SearchBot|PerplexityBot|YandexAdditional" access.log | awk '{print $9}' | sort | uniq -c
Команда считает, сколько раз роботы получили каждый код ответа. Девятое поле – код ответа в стандартном формате журнала nginx и Apache; если у вас формат другой, номер поля может отличаться.
Как читать результат:
- в основном 200 – настоящие роботы проходят, а ошибки в шаге 2 касались только подделок;
- много 403, 429 или 503 – защита блокирует настоящих роботов, нужно разбираться;
- роботов в логах нет совсем – либо они ещё не приходили, либо их отсекают раньше, на уровне CDN, и до сервера запросы не доходят. Тогда смотрите журналы CDN.
Шаг 5. Убедитесь, что пришёл настоящий робот
Подпись робота подделать легко, поэтому перед тем как просить хостинг пропустить «GPTBot», проверьте, что запросы действительно идут от OpenAI. Компании публикуют способы проверки:
- OpenAI публикует списки IP-адресов своих роботов в формате JSON: openai.com/gptbot.json, openai.com/searchbot.json, openai.com/chatgpt-user.json;
- Perplexity – perplexity.com/perplexitybot.json и perplexity.com/perplexity-user.json;
- Яндекс – инструмент «Проверка IP-адреса» в Вебмастере: он показывает, принадлежит ли адрес роботам Яндекса. Пользоваться им можно, даже если сайт не добавлен в Вебмастер;
- Google – проверка через обратный DNS: имя хоста настоящего Googlebot заканчивается на googlebot.com или google.com.
Возьмите IP-адрес из строки журнала с подписью робота и сверьте со списком. Совпало – это настоящий робот, и ошибки в его ответах – ваша проблема. Не совпало – кто-то представляется роботом, и защита работает правильно.
Anthropic отдельно предупреждает: если пытаться управлять доступом ClaudeBot через блокировку IP, это может помешать роботу прочитать robots.txt. Правила для роботов Anthropic лучше задавать в самом robots.txt.
Шаг 6. Попросите хостинг пропустить роботов, не отключая защиту
Отключать защиту целиком не нужно и опасно: она закрывает сайт от реального мусорного трафика. Правильная просьба – добавить проверенных роботов в исключения по IP-адресам из официальных списков.
Шаблон обращения в поддержку:
Здравствуйте. Сайт [адрес]. Защита от ботов отвечает 503 на запросы
роботов поисковых систем и нейросетей, при этом в robots.txt они разрешены.
Пример из журнала доступа: [дата, время, IP, адрес страницы, код ответа].
IP-адрес совпадает с официальным списком OpenAI (openai.com/searchbot.json).
Прошу добавить в исключения адреса из официальных списков:
openai.com/searchbot.json, openai.com/gptbot.json, perplexity.com/perplexitybot.json.
Отключать защиту полностью не нужно.
Если у вас свой сервер, проверьте сами:
- правила в .htaccess и конфигурации nginx, где встречаются имена ботов или слова bot, crawler, spider;
- плагины безопасности CMS, особенно на WordPress: многие блокируют «неизвестных» ботов по умолчанию;
- настройки CDN. У Cloudflare есть отдельный переключатель блокировки ИИ-ботов – убедитесь, что он выключен, если хотите попадать в ответы нейросетей;
- лимиты запросов: робот может прийти с серией запросов подряд и упереться в лимит, рассчитанный на человека.
Как часто проверять
Защиту меняют без предупреждения: хостинг обновил правила, подрядчик поставил новый плагин, CDN включил новую настройку по умолчанию. Поэтому одной проверки мало.
Рабочий ритм такой:
- раз в месяц – запускать скрипт по пяти-шести адресам;
- после любых изменений в защите, CDN, плагинах или при переезде на другой хостинг – запускать сразу;
- раз в квартал – смотреть журналы доступа по роботам нейросетей.
Что сделать сегодня
Скопируйте скрипт из шага 2 и запустите его по главной странице своего сайта и по sitemap.xml. Это две минуты. Если везде 200 и одинаковый размер – поставьте повторную проверку в календарь через месяц. Если хоть один робот получил другой код, переходите к шагу 4 и открывайте журналы доступа.
Об авторе
Ольга Белоусова – руководитель консалтинговой AI-студии ecomvibe. В прошлом – директор по e-commerce Madame Coco и Cleanelly, 15+ лет в e-commerce. Полный чек-лист видимости сайта в нейросетях – в статье «GEO и AEO простыми словами»: ecomvibe.ru/blog/geo-aeo-prodvizhenie-brenda
Источники
- OpenAI – Overview of OpenAI Crawlers: developers.openai.com/api/docs/bots
- Anthropic – Does Anthropic crawl data from the web, and how can site owners block the crawler: support.claude.com/en/articles/8896518
- Perplexity – Perplexity Crawlers: docs.perplexity.ai/guides/bots
- Яндекс Вебмастер – как запретить показ информации в ответах Алисы AI (робот YandexAdditional); проверка IP-адреса на принадлежность Яндексу
- Google Search Central – проверка запросов от роботов Google; Google-Extended
Изображение на обложке: Ольга Белоусова, ecomvibe
Комментарии