
Большой агентный отчёт способен занять обработчики, соединения и лимиты модели так, что короткие вопросы других отделов перестают получать ответы. Разбираем ограничения дерева вызовов, справедливое обслуживание очереди, разделение фоновой и интерактивной работы и проверку на стенде.
В девять утра руководитель продаж просит корпоративного помощника собрать сводку по клиентам. Агент решает проверить несколько сотен карточек, распределяет работу между помощниками и начинает обращаться к CRM. Через минуту сотрудник поддержки задаёт простой вопрос: какой срок гарантии у товара? Ответа нет. В чате стоит индикатор набора, сервер доступен, модель отвечает на контрольные запросы. Тем временем бухгалтерия тоже ждёт.
Это условный сценарий, а не история конкретного внедрения. Он показывает неприятную особенность общей ИИ-инфраструктуры: один разрешённый запрос способен занять ресурсы, которыми пользуются все остальные. Для этого не нужны злоумышленник, ошибка в промпте или тысячи пользователей. Достаточно задачи, у которой много шагов и слабые ограничения.
Разобраться помогает вопрос, который редко звучит на демонстрации: сколько времени будет ждать обычный пользователь, пока соседний отдел выполняет самую тяжёлую работу?
Сервер работает, свободных обработчиков нет
У ИИ-агента несколько мест ожидания. Входящее сообщение может ждать обработчика, вызов модели – свободного соединения, инструмент – разрешения обратиться к CRM, поиск – доступа к базе. Если смотреть только на процессор и память, перегрузку легко пропустить. Процессор свободен, потому что обработчики ждут сеть. Свободных обработчиков при этом нет.
Увеличение числа обработчиков иногда помогает, но может перенести проблему. Шестнадцать параллельных агентов быстрее упрутся в лимит провайдера модели или CRM. Если каждый создаст ещё несколько помощников, число исходящих операций вырастет снова.
Пропускная способность и справедливость – разные свойства. Система может обрабатывать много задач в минуту и одновременно плохо обслуживать отделы, которые отправляют мало запросов. Именно их жалобы часто теряются в хорошем среднем показателе.
Считать нужно работу, а не сообщения
Ограничение «десять запросов в минуту» полезно против частых обращений. Оно почти ничего не говорит о тяжести разрешённого запроса. «Найди телефон менеджера» и «проанализируй все договоры за год» занимают разные ресурсы, хотя оба пришли одним сообщением.
Разделите хотя бы четыре ограничения:
- частоту поступления новых заданий;
- число одновременно выполняемых заданий;
- размер и максимальный возраст очереди;
- объём работы внутри задания: шаги, время, дочерние вызовы, чтение данных и расход модели.
Лимиты действуют на разных уровнях: весь экземпляр, рабочее пространство, пользователь и конкретное дерево агентных вызовов. Общий предел защищает инфраструктуру. Предел на рабочее пространство оставляет место другим отделам. Предел на пользователя помогает внутри отдела. Предел дерева не позволяет одной задаче обойти ограничения через делегирование.
Важно сохранить происхождение задания. Если основной агент породил пять помощников, их работа относится к тому же инициатору и той же задаче. Выдавать каждому новый независимый бюджет – значит умножать разрешённую нагрузку при каждом уровне вложенности.
Начальные значения лучше выбирать по стенду и целевому времени ответа. Универсального числа параллельных агентов нет: оно зависит от модели, интеграций и того, сколько времени обработчик проводит в ожидании.
Нужен владелец каждой работы
В очереди у задания должны быть технически проверенные признаки: рабочее пространство, инициатор, класс задачи, время приёма и срок полезности. Отдельно полезны идентификаторы исходного поручения и родительского запуска. Они позволяют учитывать весь маршрут, даже если работу выполняет несколько сервисов.
Нельзя принимать рабочее пространство из произвольного поля сообщения или выдавать высокий приоритет потому, что пользователь написал «срочно». Эти значения назначает сервер по авторизации и правилам процесса. Иначе активный отдел быстро научится представляться несколькими отделами, а каждая задача станет срочной.
Класс работы тоже лучше определять по назначению маршрута. Сообщение в поддержку относится к интерактивному обслуживанию; ночная сверка документов – к пакетной обработке. Внутри каждого класса могут быть свои ограничения. Если классификация остаётся за моделью, сервер всё равно проверяет, разрешён ли выбранный маршрут этому пользователю.
Без этих признаков диспетчер видит безымянные сообщения. Он не сможет защитить тихого пользователя, потому что не знает, чем его ожидание отличается от очередного шага массового отчёта.
Очередь по очереди: что означает справедливое обслуживание
Простейший подход – отдельные подочереди рабочих пространств и выбор заданий по кругу. Диспетчер берёт работу у продаж, затем у поддержки, затем у бухгалтерии и возвращается к продажам. Пустую подочередь пропускает. Активный отдел использует свободную мощность, но не получает весь порядок обслуживания навсегда.
Одинаковое число выбранных заданий ещё не означает одинакового потребления. Один запрос занимает секунду, другой держит обработчик пять минут. Поэтому дополняйте порядок лимитом одновременно работающих заданий каждого пространства. Для более сложных нагрузок можно учитывать вес задачи и фактическое время занятых ресурсов, постепенно уточняя оценку после выполнения.
Оценку полезно делать грубой, но объяснимой. Например, разделить получение короткого ответа, анализ одного документа и обработку набора документов. Не стоит обещать точную стоимость до выполнения: агент может выбрать дополнительный инструмент или получить длинный результат.
Справедливость также не гарантирует мгновенный ответ. Если все обработчики уже выполняют тяжёлые задачи, перестановка ожидающих сообщений их не освободит. Нужны резерв для интерактивной работы, предел длительности тяжёлого шага либо отдельные пулы выполнения. Политику следует объяснить бизнесу: кто получает гарантированную долю, кто использует остаток, какие задачи могут ждать.
Короткий ответ и ночная сверка должны иметь разные условия
Разделите интерактивную и пакетную работу хотя бы логически. У первой короткий срок полезности и ограниченная очередь. У второй допустимо длительное ожидание, зато нужна возможность продолжить обработку после остановки.
|
Класс работы |
Что важно пользователю |
Что ограничивать первым |
|
Ответ в клиентском чате |
Предсказуемое начало ответа |
Ожидание и занятые обработчики |
|
Внутренняя консультация |
Ответ в рамках рабочего разговора |
Контекст, длительность и поиск |
|
Сводка по набору документов |
Полный проверяемый результат |
Параллелизм и объём чтения |
|
Регулярная фоновая сверка |
Выполнение к заданному сроку |
Размер партии и пересечение запусков |
Таблица описывает возможную политику, а не стандартные настройки любой платформы. Для небольшой установки достаточно нескольких классов. Десятки приоритетов усложнят разбор инцидентов сильнее, чем помогут.
У пакетных заданий должна остаться минимальная доля мощности. Если все свободные ресурсы постоянно отдавать чату, накопившиеся документы никогда не будут обработаны. Низкий приоритет без права продвигаться превращается в бессрочную паузу.
При физическом разделении проверьте зависимости: разные очереди могут обращаться к одной модели и одному пулу соединений. Отдельный обработчик сам по себе не изолирует общий внешний API.
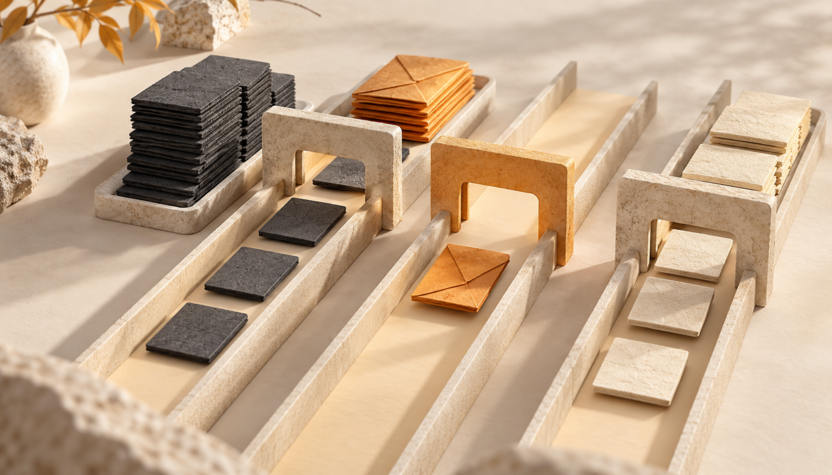
Отдельные очереди и ограничения по клиентам помогают распределять общую вычислительную мощность. Изображение: AiHummer
Ограниченная очередь честнее бесконечного ожидания
Когда приём быстрее выполнения, очередь растёт. Она не создаёт дополнительную мощность, а сохраняет обязательства, которые системе предстоит выполнить. Чем дольше ожидание, тем выше шанс, что пользователь уже решил вопрос и результат потерял смысл.
Задайте предел на количество ожидающих заданий и их возраст. Проверка лимита и постановка в очередь должны быть согласованы: два параллельных процесса не должны оба увидеть последнее свободное место и занять его. Для распределённой системы одной проверки длины в памяти недостаточно.
При отказе в приёме сообщайте конкретное состояние: задание не принято, повтор возможен позже; либо задание принято и имеет идентификатор, по которому можно узнать результат. Эти ответы задают разное поведение клиента. Размытое «что-то пошло не так» провоцирует повторные нажатия и добавляет нагрузку.
Для HTTP-интерфейса ограничение частоты можно обозначать статусом 429; предусмотренный протоколом Retry-After сообщает, когда имеет смысл повторить запрос. Это подсказка клиенту, а не гарантия свободного обработчика к указанной секунде. Повторы тоже ограничиваются: нельзя превращать отказ в бесконечный поток одинаковых попыток.
Отдельно решите, что показывать в чате. Пользователю полезнее увидеть «отчёт ожидает обработки», чем несколько минут наблюдать за индикатором, который выглядит как работа модели.
Срок задания проходит через весь маршрут
У задания есть общий бюджет времени. Если оно провело большую часть этого времени в очереди, нельзя выдавать каждому следующему инструменту полный исходный тайм-аут. При запуске проверяется оставшийся срок; дочерний вызов получает предел, который в него помещается.
Остановка должна доходить до дочерних агентов и процессов, иначе главный ответ завершился, а работа продолжает занимать ресурсы. При этом отмена ожидания не откатывает изменение во внешней системе. Для операции, результат которой неизвестен, нужна проверка состояния; дополнительный повтор без проверки способен создать новое изменение.
Ожидание согласования человеком заслуживает отдельного состояния. Несколько часов на одобрение не должны занимать сетевое соединение или активного обработчика. После разрешения задача снова проходит действующие проверки и получает место для исполнения. Сроки такого ожидания и срок выполнения полезно хранить раздельно.
Для регулярной работы учитывайте пересечение запусков. Если сверка выполняется дольше своего интервала, новое расписание будет добавлять задолженность быстрее, чем система её закрывает. Допустимые решения зависят от задачи: пропустить устаревший запуск, объединить проверки или сохранить каждую отдельно. Выбор фиксируется заранее, а не рождается внутри очереди.
Медленный сервис требует собственного ограничения
Допустим, CRM стала отвечать в десять раз дольше. Число поступающих вопросов не изменилось, но каждый вызов теперь дольше удерживает соединение. Общий пул постепенно заполняется ожидающими операциями. Другой агент, которому CRM вообще не нужна, тоже теряет обработчика.
При восстановлении сервиса не отправляйте весь накопившийся объём одновременно. Начните с допустимого параллелизма и повышайте его по подтверждённым результатам. Для просроченных заданий сначала решите вопрос актуальности. Восстановившаяся CRM не делает вчерашний краткий запрос снова полезным.
Отдельная тревога может сообщать оператору, что перегружена именно эта интеграция. Это конкретное основание отложить связанные отчёты, а не добавлять процессоры всему серверу. Пользователю при этом сообщается состояние его задачи: ожидает доступной интеграции, прекращена по сроку или передана на разбор.
Смотрите на тихих пользователей
Среднее время ответа скрывает распределение. Нужны как минимум время ожидания, время выполнения и полное время до результата. Снимайте их отдельно по классам задач и рабочим пространствам. p95 показывает границу, в которую укладываются 95% наблюдений, но на малой выборке этот показатель следует трактовать осторожно.
Дополните картину возрастом самого старого задания, числом отказов в приёме, занятым параллелизмом, расходом дерева вызовов и долей задач, потерявших актуальность до старта. Для отложенных согласований нужна отдельная статистика, чтобы часы ожидания человека не выглядели медленной моделью.
Технический журнал связывает запрос пользователя, задание в очереди и дочерние операции. Содержимое договоров и сообщений для этой связи не требуется: обычно достаточно идентификаторов, этапов, времени и причины остановки. Подробную телеметрию храните в соответствии с доступами компании.
Испытание, которое стоит устроить до запуска
Создайте два тестовых рабочих пространства. Первое отправляет тяжёлую пакетную работу, второе – редкие короткие вопросы. Зафиксируйте допустимое ожидание второго до испытания. Затем добавьте медленную CRM, делегирование помощникам и всплеск повторных запросов.
Если стенд проходит испытание только с одинаковыми запросами, он ещё не проверяет соседство разных нагрузок. Именно различие их длительности и числа шагов создаёт проблему.
Единая платформа нужна для общих границ
Когда чат, голосовой помощник и обработчик документов живут в отдельных скриптах, каждый ограничивает свою очередь. Все три при этом расходуют один договор с провайдером и обращаются к одной CRM. Локально каждый соблюдает правила, вместе они перегружают общий ресурс.
Единая агентная платформа даёт место, где можно связать пользователя, рабочее пространство, маршрут, бюджет и дерево выполнения. В AiHummer, например, политика выполнения агента описывает ограничения контекста, сессий и дочерних вызовов. Наличие этих настроек не доказывает справедливость любой развёрнутой очереди: её нужно отдельно проверить на своих нагрузках и интеграциях.
Начните с одного испытания: запустите большой отчёт и одновременно задайте помощнику короткий вопрос из другого отдела. Замерьте ожидание, найдите общий ресурс и назначьте ему владельца политики. Такой эксперимент быстро показывает, где автономность одного агента оплачивается временем всех остальных.
Изображение на обложке: AiHummer
Комментарии